SK海力士與英偉達罕見同時加註CPO。SK海力士發表論文設定下一代AI互聯技術目標,英偉達則宣佈全球首款200G/lane CPO交換機量產。CPO旨在破解數據中心功耗與信號損耗難題,但現階段滲透率僅約0.5%,將與可插拔光模塊長期並存,產業鏈價值正向上游光芯片與先進封裝轉移。
最近,半導體行業被一個詞攪得發熱——CPO。英偉達和SK海力士,一個掐着算力的命門,一個攥着存儲的咽喉,這次罕見地同時坐不住了。
SK海力士、英偉達,加註CPO
近日,SK海力士及其全球研究團隊在《自然·電子學》雜誌上發表了一篇論文。該論文探討了用於高性能計算和人工智能的共封裝光學器件(CPO)的開發,指出了關鍵的技術挑戰,並概述了下一代光互連技術的發展軌跡。
SK 海力士人工智能基礎設施團隊負責人洪承勳和弗吉尼亞大學(UVA)電氣與計算機工程系李奎相教授擔任通訊作者,領導了一項與伊利諾伊大學厄巴納-香檳分校(UIUC)、南洋理工大學(NTU)、麻省理工學院(MIT)和延世大學的研究人員合作的研究。
從更廣泛的層面來看,該論文提出了一個全面的技術路線圖,闡述了存儲器、先進封裝和光計算互連(OCI)應如何協同演進以支持下一代人工智能系統。至關重要的是,它還展示了SK海力士如何超越HBM創新,在系統層面幫助定義下一代人工智能基礎設施的架構。
與此同時,研究人員為下一代人工智能基礎設施設定了明確的技術目標,包括每個節點超過 100 Tb/s 的帶寬、低於 1 pJ/bit 的能耗以及小於 10 納秒的芯片間延遲。該論文還提出了一個全面的技術路線圖,概述了從基於 2D 和 2.5D 中介層的配置到 3D 異構堆疊的演進過程,以及商業部署必須解決的關鍵技術挑戰。
無獨有偶,8月14 日,英偉達正式宣佈 SpectrumX Ethernet Photonics 共封裝光學交換機進入全面量產階段,面向AI 工廠,打造下一代大規模擴展網絡基礎設施,這是全球首款量產級200G/lane共封裝光學交換機系統。英偉達官方數據顯示,對比傳統可插拔光模塊方案,它可實現 5 倍網絡功耗效率提升、5 倍 AI 應用不間斷運行時長提升,平均故障間隔時間 MTBF 更是拉長 10 倍,大幅改善超大規模 AI 集群網絡的功耗與可靠性短板。
CPO忽然成了SK海力士和英偉達共同押注的方向,這不是巧合。背後的推力只有一個:數據中心撐不住了。
數據中心,需要CPO了
最早一代數據中心內部互連大量使用銅纜 DAC 直連,交換芯片依靠 OSFP、QSFPDD 連接器接入 DAC 電纜,以純電氣信號完成短距離傳輸。銅纜方案優勢突出:成本低廉、部署簡單,不需要光電轉換器件,短距離場景功耗可控。但短板同樣致命,高速信號下銅線衰減嚴重,傳輸距離大多僅有數米,帶寬提升之後功耗快速走高,完全無法適配高密度、超大帶寬的 AI 算力集群,如今已經逐步被光學互連替代。
之後行業全面進入可插拔光模塊時代,也就是現在產業的主流狀態。
交換芯片板卡通過 OSFP、QSFPDD 連接器,外接獨立的可插拔光收發模塊,再通過光纖完成遠距離信號傳輸。可插拔光模塊最大優勢就是靈活:支持熱插拔,故障之後直接更換模塊即可恢復業務,升級迭代也十分方便,標準化形態適配絕大多數雲廠商數據中心。但這套架構的短板,在超高帶寬 AI 集群中被無限放大:交換芯片到面板光模塊之間,依然存在一段釐米級高速電氣走線,高速信號傳輸過程中出現損耗、串擾,為補償信號損失,光模塊內部 Retimer 重定時器、均衡器持續消耗功耗,整機網絡功耗居高不下。
對於普通互聯網數據中心,800G、1.6T 可插拔光模塊依然夠用;但面對幾十萬卡規模 AI 訓練集群,交換機端口數量成千上萬,大量端口疊加之後,額外功耗、信號損耗會成為整個算力集群的沉重負擔,傳統可插拔架構開始觸碰物理天花板。
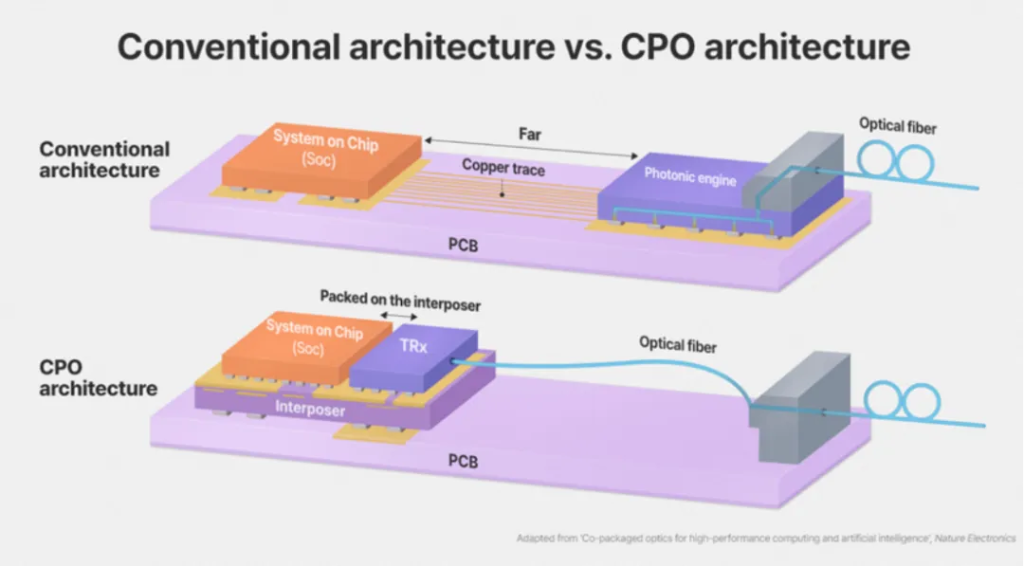
CPO 正是為破解這一矛盾而生。CPO 架構將電光轉換環節遷移到芯片封裝內部,高速電信號傳輸距離壓縮到幾毫米,規避長距離高速銅走線帶來的信號損耗,同時省去部分 DSP 信號處理開銷,實現功耗、延遲、可靠性的全面優化。
200G/lane之前,CPO 用的是多少?
不過,隨着英偉達的200G/lane CPO 以太網交換機發布,諸多讀者的第一反應是疑惑:業內不是已經在大量談800G、1.6T光模塊了嗎?英偉達這纔出200G,是不是落後了?CPO 和傳統可插拔光模塊有什麼區別?它對國內那些如日中天的光模塊公司意味着什麼?
想要回答這些問題,首先要釐清一組極易混淆的概念:200G/lane 描述的是單條光通道速率,800G、1.6T 是單端口總速率,二者不屬於同一維度。
光模塊端口總速率計算公式為:總速率 = 單通道速率 × 通道數,通道數一般為 4、8、16 這類 2 的冪次。舉幾個行業常見實例:8×50G=400G,8×100G=800G。因此,200G/lane 不是落後的新技術,恰恰是下一代高速互聯的底層物理基礎。
在本次 200G/lane 實現量產之前,CPO 產業的技術探索長期停留在 50G/lane、100G/lane。那為什麼行業一定要把單通道速率推進到 200G/lane?根源來自 AI 算力爆炸帶來的網絡底層壓力。
隨着 GPU 架構從 Hopper 迭代至 Blackwell,並且面向未來 Rubin 架構演進,單顆 GPU 對外通信帶寬出現爆發式增長。如今大型 AI 訓練集群動輒部署幾十萬、上百萬張 GPU,交換機需要承載的總交換容量達到前所未有的水平。如果繼續停留在 100G/lane,想要實現 102.4T 級別交換機總容量,就必須成倍增加物理通道數量。直接後果就是交換芯片面積急劇膨脹,PCB 電路板佈線密度觸碰物理極限,整機功耗徹底失控,機櫃供電、散熱都無法承載,單純依靠堆疊通道數的老路已經走不通。
CPO 共封裝光學的本質,是打破延續多年的 「交換芯片與光模塊相互分離」 的傳統架構,將包含激光器、調製器、探測器的光引擎,和 ASIC 交換芯片共同封裝在同一塊基板之上,把電信號傳輸路徑從傳統方案的釐米級壓縮至毫米級,從根源解決傳統互連架構的功耗、信號衰減、帶寬瓶頸。
當然,CPO 賽道並不只有英偉達一家。博通在 2025 年 10 月就發布第三代 CPO 交換芯片 Tomahawk 6Davisson(TH6Davisson),實現 102.4Tbps 交換容量,帶寬較上代直接翻倍。更早之前,博通已經推出 Bailly CPO 交換機,集成八顆 6.4Tbps 硅光子光引擎,對比傳統可插拔方案,互連運行功耗降低 70%,硅面積使用效率提升 8 倍。
光模塊公司的尷尬
但當拆解英偉達 SpectrumX 完整供應鏈名單時,可以發現,英偉達這套量產 CPO 交換機的核心合作分工十分清晰:台積電負責硅光子芯片工藝製造,矽品精密承擔晶圓級、芯片級封裝測試,Lumentum 提供激光芯片,天孚通信負責激光器模塊子組件組裝,鴻海完成整機系統組裝交付。
值得深思的一點:這份核心供應商清單中,沒有中際旭創、新易盛等這類傳統可插拔光模塊組裝大廠。
這直接戳破行業現實:CPO 架構之下,不需要傳統形態、面板插拔式光模塊。光引擎不再作為獨立外接部件,而是直接集成進交換機封裝內部。這就引出全行業最核心的命題:CPO 的到來,是否意味着可插拔光模塊時代的終結?以組裝、集成可插拔光模塊為核心優勢的國產龍頭企業,會面臨怎樣的行業變局?
首先要明確核心結論:CPO 實現量產,不等於可插拔光模塊會快速退出市場,二者將長期並存,行業進入雙線驅動階段。
多家 A 股光通信企業以及雲服務商的網絡規劃信息顯示,2026-2027 年,全球雲廠商網絡建設規劃,依舊以可插拔光模塊作為主力,沒有任何頭部雲廠商計劃在未來兩到三年大規模部署 CPO 交換機。TrendForce 數據顯示,現階段 CPO 在 AI 數據中心光互連市場滲透率僅約 0.5%,仍然處於商業化早期;IDC 機構預測,CPO 大規模商用窗口落在 2027-2028 年之後。
同時也必須客觀看待 CPO 在運維層面的固有短板,這也是雲廠商不敢貿然全面替換的關鍵。傳統可插拔光模塊故障,運維人員直接更換單個模塊,幾分鐘即可完成故障修復,業務幾乎無感知。而 CPO 架構光引擎和交換芯片深度綁定,一旦光子芯片、光引擎出現故障,可能同時造成 832 個端口同時失效,維修往往涉及整機、整個交換單元返修,運維複雜度、停機代價顯著提升。
只有當未來 CPO 產品良率持續爬坡,單位成本下降到臨界點之後,整個產業鏈價值分配纔會發生實質性傾斜:產業鏈價值重心,會從傳統光模塊組裝環節,向上遊光芯片、硅光子芯片、先進光電封裝環節轉移。
回到國產廠商的現實處境,CPO 浪潮之下,國內光通信行業並不是簡單的 「危機降臨」,而是一場產業鏈重構,機遇和挑戰同時存在。
擺在國內光模塊龍頭面前,是三條現實路徑。第一,守住基本盤,持續迭代 800G/1.6T/3.2T 可插拔光模塊,抓住未來 2-3 年全球 AI 算力建設的主流量需求。第二,向上遊延伸,佈局光引擎、硅光子、高速光芯片、光電聯合封裝,跳出單純模塊組裝,切入 CPO 高價值環節。第三,佈局 NPO 等近封裝光學等過渡技術路線,NPO 技術難度相對低於 CPO,更適配國內雲廠商的現實條件,是國內廠商實現技術落地的重要賽道。