在 Kimi K3 正式官宣倒計時的前幾個小時,海外 AI 圈的空氣已經被各種爆料、實測和跑分徹底點燃。
博主 Elaina 的一通激情刷屏被瘋狂轉發。她形容 K3:「有史以來最好、最大的前沿開源模型,兼具原生視覺與極高品味;這是又一次‘DeepSeek R1 時刻’;權重完全開源,而性能僅次於 Fable 5」
博主 Elaina 的推文,配圖為月之暗面預熱視頻中一閃而過的"3"
幾個小時後,預言落地。月之暗面通過官方公衆號正式揭曉了 Kimi K3 的神祕面紗:2.8 萬億參數、原生視覺理解、100 萬 Token 默認上下文。
這不僅是全球首個步入 3 萬億量級的開源模型,更是一次宣告開源「硬剛」閉源的里程碑式跨越。
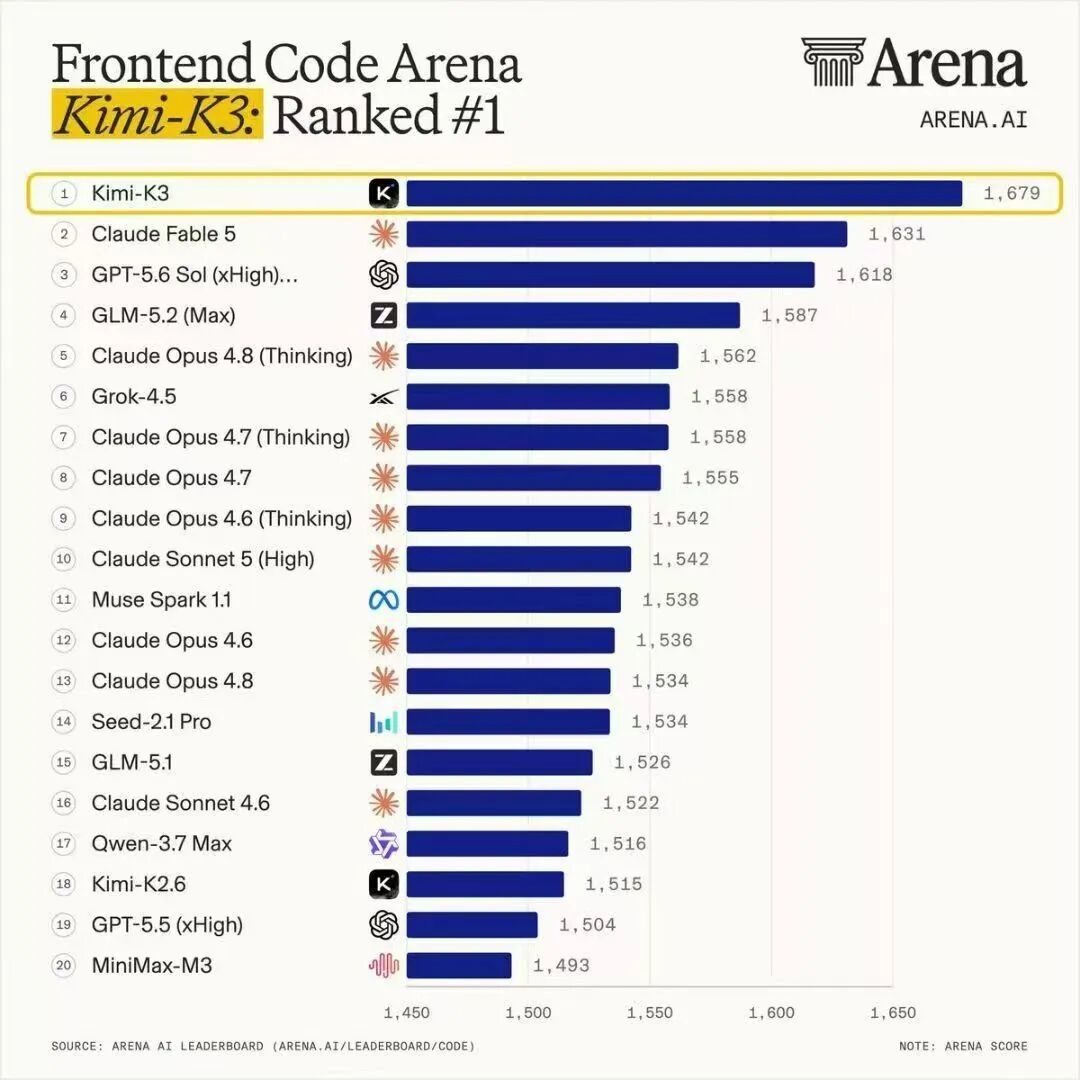
與官宣一同引爆科技圈的,還有啱啱刷新的各項權威排行榜。在高手如雲的 Frontend Code Arena(前端代碼競技場)上,Kimi-K3 斬獲了 1679 分的屠榜成績,強行超越閉源雙雄 Claude Fable 5(1631分)與 GPT-5.6 Sol (xHigh)(1618分)成功登頂。
與此同時,Artificial Analysis 發布的最新 AI 智力指數排行榜也印證了這一強悍實力:數據顯示,Kimi K3 斬獲 57 分的高分,智能水平直逼 Opus 4.8 和 GPT-5.5。
K3的表現甚至驚動了科技巨頭埃隆·馬斯克(Elon Musk),他在該動態下親自下場回覆,用一個詞給出了極高的讚賞:「Impressive」(令人印象深刻)。


比起參數,最重的籌碼在架構與 Agent
K3 擁有 2.8 萬億的龐大參數,基於 KDA 混合線性注意力機制與注意力殘差技術構建,原生支持視覺理解,並擁有 100 萬 token 的長上下文窗口,專為長程編程、高強度知識工作與推理場景而生。
從官方公布的跑分數據來看,K3 整體表現雖然仍略微遜色於最頂級的閉源旗艦模型 Claude Fable 5 和 GPT-5.6 Sol,但在全套評測中依然展現出了行業最前沿的水平,並穩定超越了除此之外的所有模型。
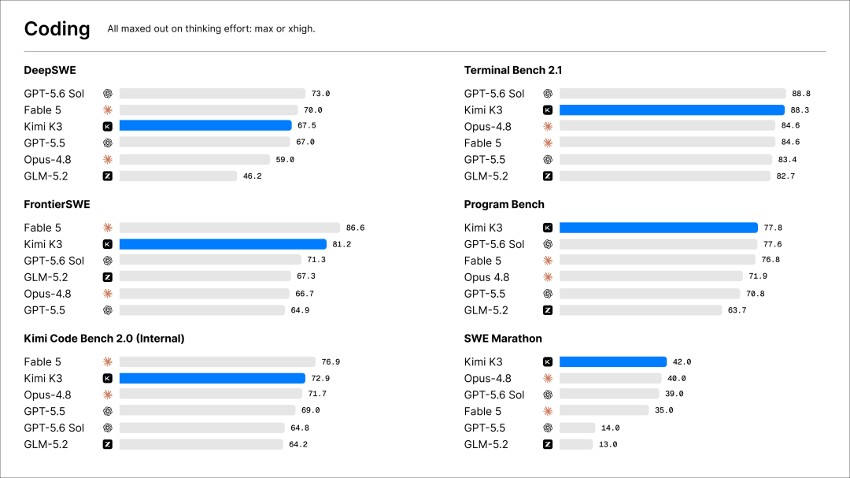
在六個核心編程基準測試中,K3 展現了恐怖的爆發力:
Terminal Bench 2.1(終端代碼生成與調試):K3 拿下 88.3 分,與榜首 GPT-5.6 Sol 僅有 0.5 分的毫釐之差,直接將 Opus 4.8 和 Fable 5(均為 84.6 分)挑落馬下。
Program Bench(複雜編程任務的端到端完成度):K3 憑藉 77.8 分直接登頂。
SWE Marathon(極限編碼挑戰):K3 轟出 42.0 分的強悍成績領跑全場。作為對比,Opus 4.8 為 40.0 分,而閉源旗艦 Fable 5 僅有 35.0 分。
在 Agent 智能體類基準中,這種統治力更加明顯。
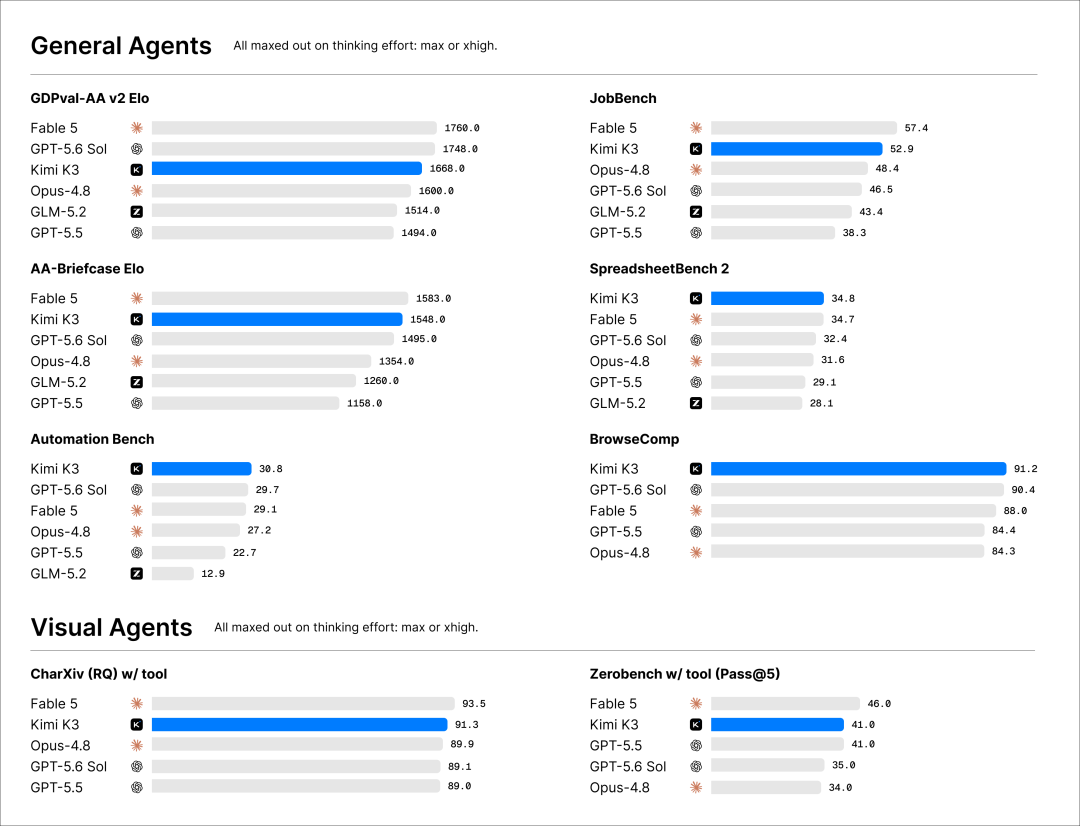
BrowseComp(網頁瀏覽智能體):91.2 分,全場第一。
SpreadsheetBench 2(表格處理智能體):34.8 分,全場第一。
Automation Bench(自動化智能體):30.8 分,全場第一。
在考驗多模態視覺智能體能力的 CharXiv 上,K3 斬獲 91.3 分的高分,成了唯一能緊跟 Fable 5 的開源模型。
但對整個大模型商業生態而言,比跑分更具殺傷力的,是K3展現出的成本效率。
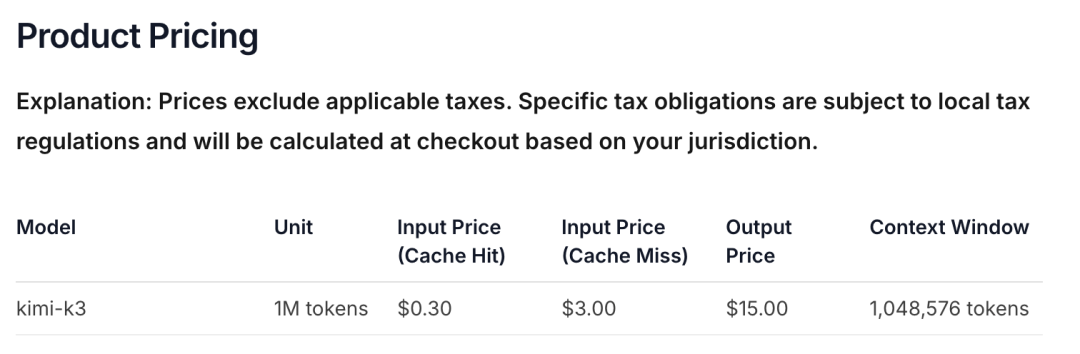
從絕對價格看,K3並不算便宜:緩存命中輸入為0.3美元/百萬Token,普通輸入3美元,輸出15美元,上下文窗口約100萬Token。它沒有延續中國開源模型慣用的「地板價」策略,而是直接進入國際主流商業模型的定價區間。不過,與Fable 5、GPT-5.6和Opus等旗艦模型相比,K3仍然便宜不少。
真正拉開差距的,是完成任務的實際成本。
官方「分數—成本」散點圖顯示,在Kimi Code Bench V2上,K3 Max以單次約4美元的成本取得72.9分;Fable 5雖然達到76.9分,單次成本卻超過10美元。在BrowseComp中,K3更以全場最低的運行成本拿下最高分。
換句話說,K3的優勢並不只是Token更便宜,而是能以顯著更低的成本,提供接近頂級閉源模型的能力。這種「旗艦性能、零頭成本」的結構性優勢,纔是K3砸向閉源陣營最沉重的一記鐵拳。
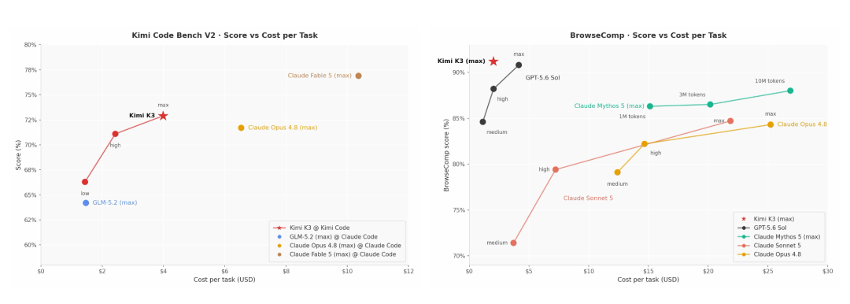
官方分數-成本散點圖,K3 的單任務成本約為 Fable 5 的三分之一
能力強、成本低,答案寫在架構裏。
K3 基於 KDA 與注意力殘差構建,官方解釋為"讓信息在更長序列和更深模型中流動得更順暢";MoE 的稀疏度進一步擴大,結合 Stable LatentMoE 框架後,模型可以在 896 個專家中高效激活 16 個;再疊加訓練方法與數據配方的優化,K3 相比 K2 的整體擴展效率提升約 2.5 倍。
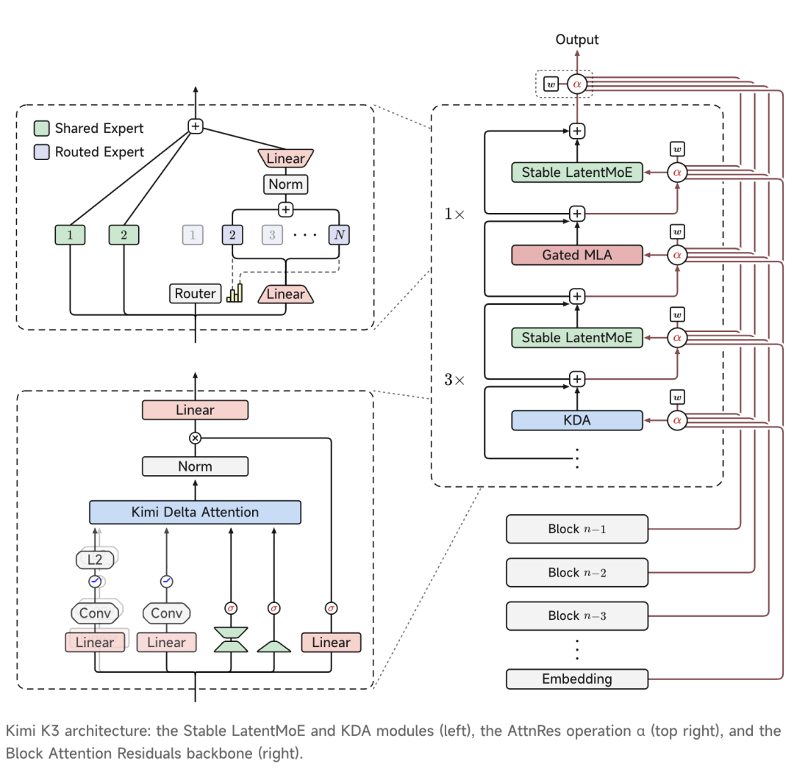
K3 架構圖,Stable LatentMoE 與 KDA 模塊(左)、注意力殘差操作(右上)與 Block Attention Residuals 主幹(右下)
2.8 萬億參數讓 K3 成為最接近 3 萬億量級的開源模型。過去 12 個月中的 9 個月,開源模型的規模上限由 Kimi 保持。從 K2 的 1 萬億到 K3 的 2.8 萬億,DeepSeek V4 Pro 的 1.6 萬億、小米 MiMo V2.5 Pro 的 1.02 萬億都被甩在身後。
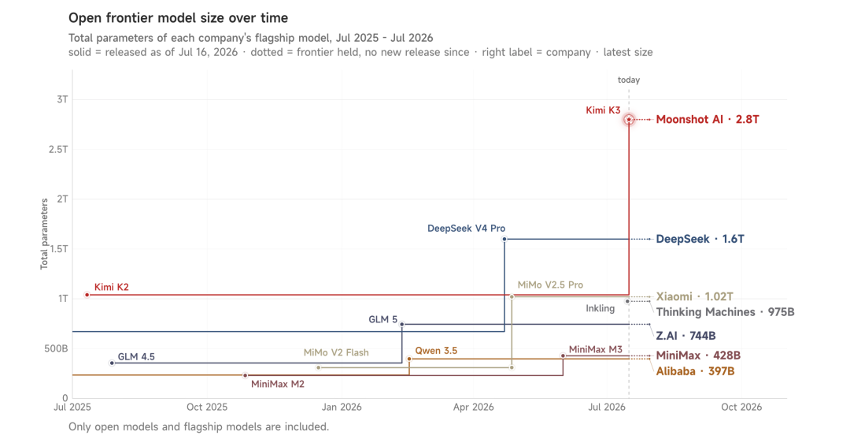
開源旗艦模型規模演進,K3 以 2.8 萬億參數登頂
目前,K3 已在第一時間內全線接入,用戶可以通過官網、最新版 Kimi App、Kimi Work 桌面客戶端、Kimi Code 以及 Kimi API 搶先體驗。

實測 K3:超預期爆發,向閉源旗艦正面亮劍
排行榜抬得再高,終究要靠實測說話。
(一)複雜 UI 的視覺解析與代碼重構
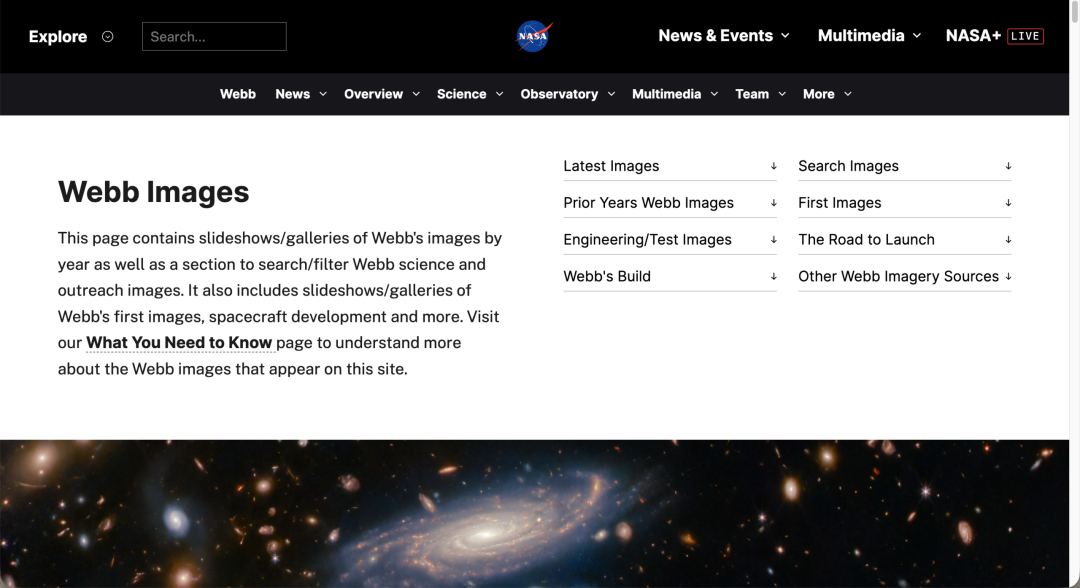
第一道題,我們選擇了一張 NASA Webb Images 頁面截圖,要求 K3 扮演資深前端工程師,僅根據視覺信息,將頁面重構為可直接運行的單文件 HTML。
這道題考驗模型的視覺理解、空間佈局分析、組件拆解和前端工程能力。參考頁面包含兩級導航欄、搜索框、NASA 品牌標誌、左右分欄的正文與分類入口,以及底部的大幅天文圖片。模型不僅需要識別頁面中有什麼,還要判斷各元素之間的層級、比例、間距與對齊關係,並將這些視覺信息轉譯成合理的 HTML 和 CSS。
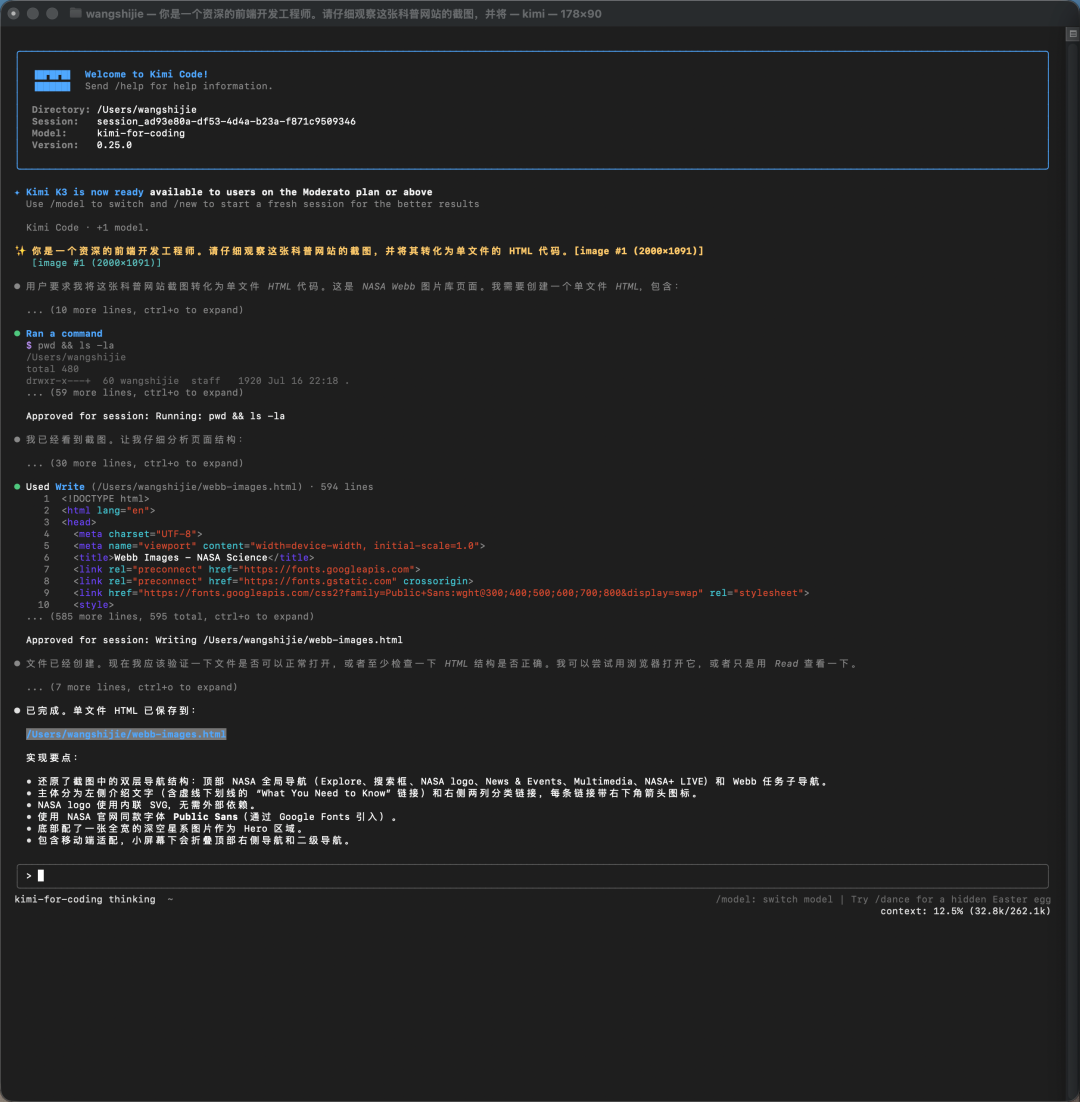
從運行過程來看,K3 很快完成了頁面結構拆解,隨後一次性生成了一份約 594 行的單文件 HTML,並加入 SVG 圖形、Google Fonts 字體和移動端響應式適配。整個過程中沒有要求我們補充頁面源碼、設計參數或切圖素材。
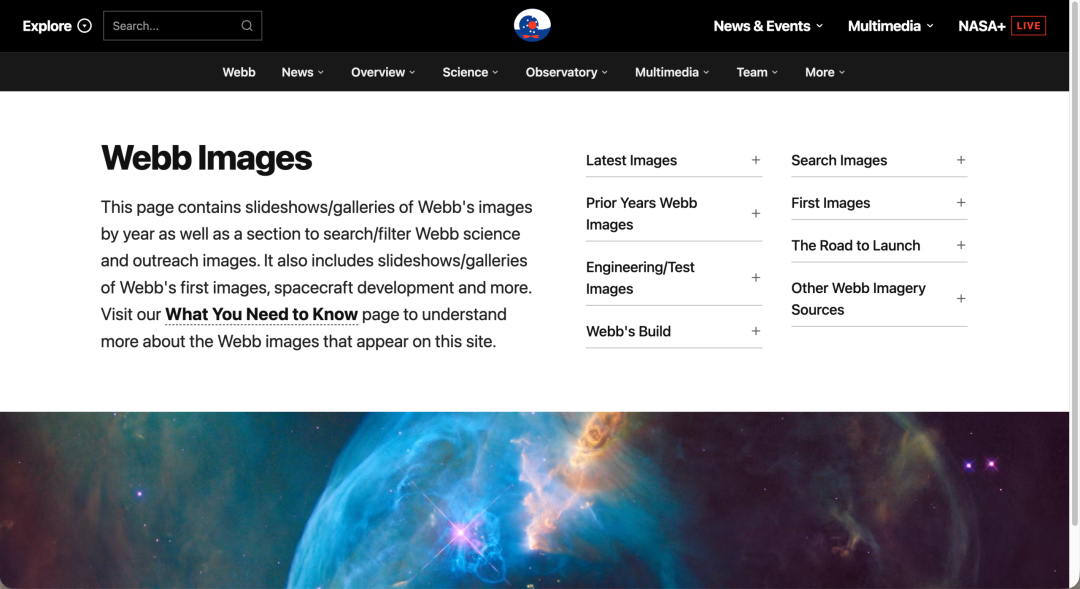
實際渲染結果顯示,K3 準確抓住了原頁面的主體骨架:頂部的 NASA 全局導航與 Webb 專題導航被完整區分;「Webb Images」標題、介紹文字以及右側兩列分類入口均得到還原;黑、白、深灰組成的整體配色,以及底部橫向鋪開的天文圖片區域,也延續了原網頁的視覺風格。即使脫離原始網站,這個頁面依然能夠獨立運行,整體完成度明顯超過簡單的靜態排版拼接。
更值得注意的是,K3 並不是機械地把截圖轉換成一張不可交互的「網頁圖片」,而是按照真實前端頁面的方式組織內容。導航、搜索框、列表和響應式佈局都被拆解成了獨立的界面元素,說明模型已經能夠從像素層面進一步推斷頁面背後的結構邏輯。
(二)複雜業務邏輯與動態數據可視化計算
第二道題,我們不再向 K3 提供參考截圖,而是交給它一份包含28條記錄的多模型 API 運營數據、一套品牌視覺規範和一個 SVG 標誌,要求其從零設計並實現一套多模型 API 運營駕駛艙。
相較於第一題的截圖復刻,這道題更接近真實的數據產品開發。模型不僅需要決定頁面長什麼樣,還要正確理解請求量、成功請求、Token 消耗、延遲、成本和質量分等字段,將原始數據轉換為業務指標、趨勢圖表和異常信息。最終頁面必須採用單文件 HTML,所有數據、樣式和腳本均需內嵌,並且不得使用第三方圖表庫或聯網資源。
從生成文件來看,K3 最終交付了一份約876行、44KB的單文件 HTML。它遵循了 AstraOps 的深色視覺規範,正確使用了提供的品牌標誌和模型顏色映射,並自行建立了一套信息密度較高的專業駕駛艙佈局。
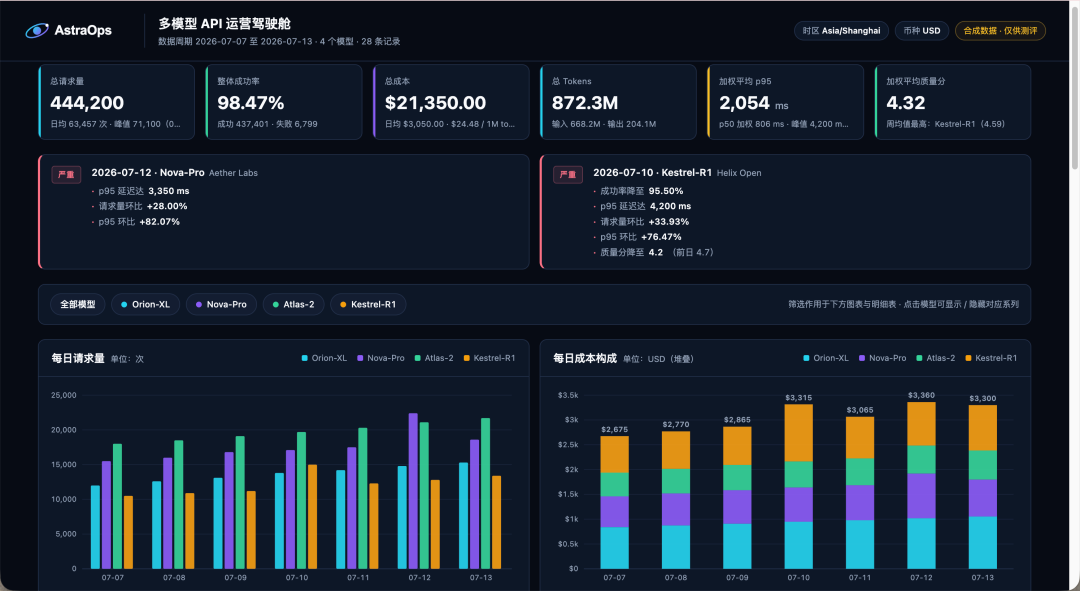
頁面頂部集中展示了總請求量、整體成功率、總成本、Token 消耗、加權 P95 延遲和加權質量分等六項指標。更關鍵的是,K3 沒有簡單地對每日百分比或延遲進行算術平均,而是根據請求量重新計算了總體成功率與加權延遲。
這些核心數據均與標準答案一致,說明 K3 對統計口徑的理解是準確的。對於這類任務而言,「把圖畫出來」並不困難,真正容易出錯的是分母、權重和聚合範圍,而 K3 在最關鍵的基礎計算上沒有失手。
在數據可視化方面,K3 沒有調用外部圖表庫,而是使用原生 SVG 繪製了每日請求量、每日成本構成、P50/P95延遲趨勢和每日成功率四組圖表。頁面還提供了模型圖例切換、圖表懸停提示、P50與P95切換、模型顯示與隱藏以及明細表排序等功能。四個模型分別擁有獨立的周度匯總卡片,可以查看請求量、成功率、成本、質量分、單位成本、Token用量和延遲峯值。
不過,嚴格對照提示詞,這份結果仍存在些許缺陷。頁面只實現了模型維度的顯示與隱藏,沒有實現要求中的日期範圍和Provider篩選。模型篩選也只作用於圖表和明細表,並未同步更新頂部指標、異常區域和模型匯總卡,尚未形成完整的全局狀態聯動。
(三)複雜規則驅動的建築疏散仿真
第三道題,我們把難度從生成一個能看的網頁進一步推向實現一個真正會運行的動態系統。我們向 K3 提供了一份建築疏散場景 JSON 和一套仿真規則,要求它為城市應急管理人員設計並實現一個可交互的「建築疏散仿真與決策沙盤」。最終交付仍需是可離線運行的單文件 HTML,不允許使用第三方庫、遊戲引擎、聯網資源,也不能用預設動畫或寫死軌跡冒充實時計算。