當地時間8月26日,谷歌發布最新語音轉文本模型Gemini 3.5 Transcribe,該模型不僅主打更高的識別準確率,更將能力邊界從逐字記錄延伸至理解說話人意圖並自動整理輸出結果,標誌着語音識別技術向更深層的語言理解邁進。
與傳統語音識別工具不同,Gemini 3.5 Transcribe能夠識別說話人的自我修正、自動刪除口頭禪,並直接將非結構化口語轉換為格式化文本。
谷歌稱其為迄今"最精準"的語音轉文本模型,並已將其引入Android版Gboard及Mac版Gemini應用,同時通過Gemini API向開發者開放預覽。
此次發布與Gemini 3.5 Live及Gemini 3.5 Live Experimental同日推出,共同構成谷歌新的Gemini Audio系列。
分析人士指出,隨着語音入口加速滲透谷歌旗下Chrome、Gboard等高頻產品,語音交互有望逐步替代鍵盤輸入,成為用戶與AI系統的主要連接方式。
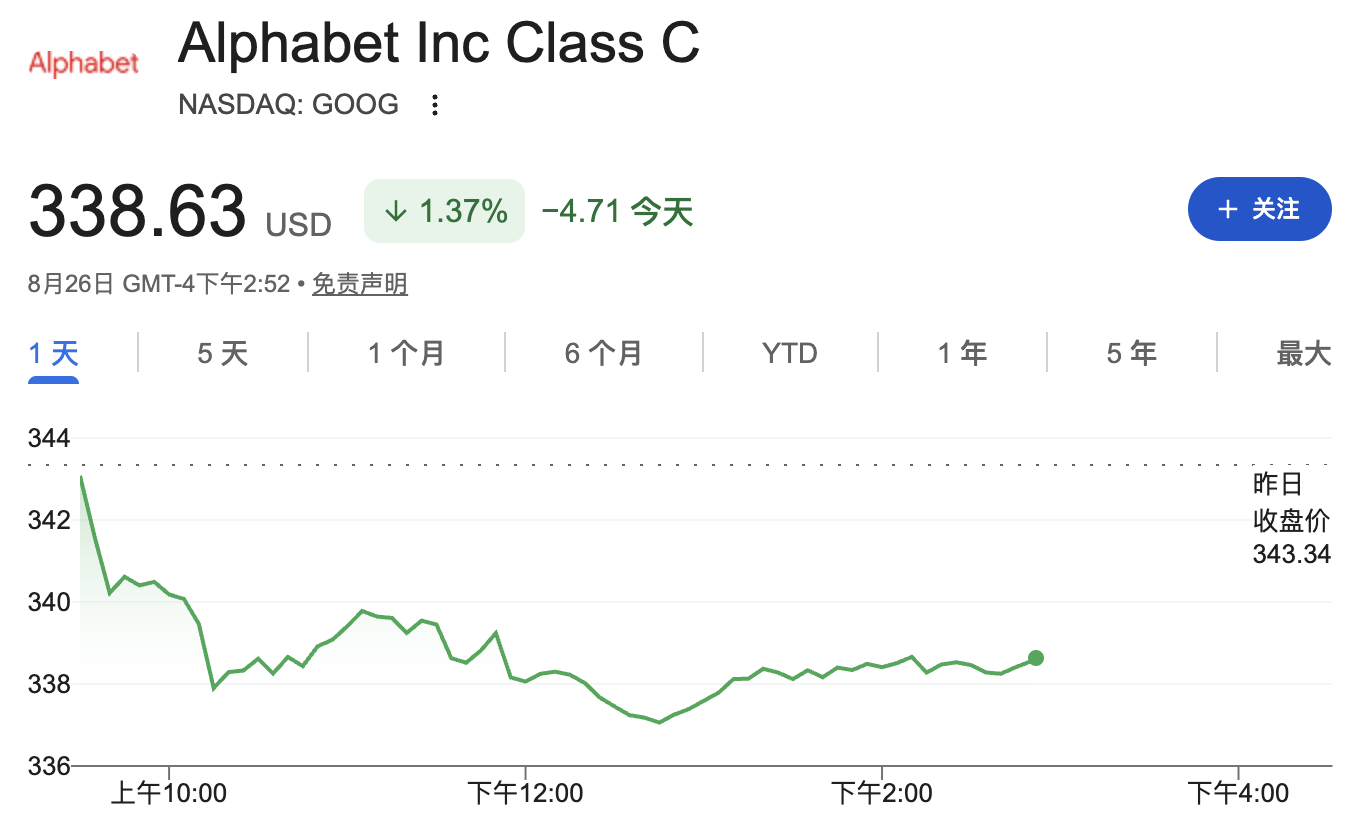
截至發稿,谷歌股價周四盤中下跌1.37%。
從"逐字記錄"到"意圖理解"
Gemini 3.5 Transcribe的核心升級在於對自然語言的語境理解能力。分析指出,此次發布的關鍵不僅是提升傳統意義上的識別準確率,而是讓模型能夠在轉錄過程中理解說話人意圖,並對原始語音進行"編輯"。
具體而言,當用戶說出"周二——不,周三見面"時,模型可識別出這是一次自我修正,而非將兩種表述全部記錄下來。
與此同時,模型會自動刪除"um""uh"等口頭禪,並完成標點符號和文本格式的整理。該模型能夠將凌亂、非結構化的口述內容直接轉化為格式化文本。
在語言覆蓋方面,該模型支持超過85種語言,具備自動語言識別能力,並能處理多語言混說場景。谷歌還允許用戶添加自定義詞彙,使模型更準確地識別專業術語、特殊拼寫及訂單號、郵編等字母數字組合。對於預錄音頻,模型還支持說話人識別和逐詞時間戳。
開發者接口與產品落地雙線推進
在面向開發者的能力開放層面,Gemini 3.5 Transcribe已通過Gemini API進入預覽階段,支持實時語音流與錄製音頻文件兩種處理場景。
據谷歌官方文檔,文件轉錄最長支持1小時,實時轉錄則面向低延遲應用場景。開發者可調用低延遲轉錄、自定義詞彙及智能格式化等功能,將語音識別能力嵌入自有應用。
在產品端,Gemini 3.5 Transcribe已落地Android平台的Gboard Rambler語音輸入功能及Mac版Gemini應用。
谷歌還計劃將其引入Chrome瀏覽器,屆時用戶可在網頁文本輸入框內直接通過語音輸入內容,涵蓋回覆消息、撰寫帖子及向Gemini發出指令等場景。
語音入口之爭背後的商業邏輯
此次發布是谷歌系統性推進Gemini"語音入口"戰略的組成部分。
谷歌正將Gemini的能力從文本和圖像進一步延伸至實時對話、語音翻譯和語音輸入等場景,Gemini 3.5 Transcribe、Gemini 3.5 Live及Gemini 3.5 Live Experimental共同構成其Gemini Audio系列。
從商業化視角看,語音轉文本正從單純的後台基礎能力演變為AI應用的重要交互入口。隨着模型具備"聽懂—理解—整理—執行"的一體化能力,用戶與AI的交互方式有望從鍵盤輸入向語音指令轉移。
對谷歌而言,將Gemini 3.5 Transcribe嵌入Chrome、Gboard、Docs、Gmail等高頻產品,有望進一步擴大Gemini在日常生產力場景中的滲透深度,並在語音交互這一新興入口上鞏固其競爭地位。