Astra發布前幾個小時,AI圈先亂成了一團。
9月3日晚間,ChatGPT、Claude和Grok幾乎同時出現大範圍服務異常,大量用戶不是打不開模型,就是請求失敗。
恰在此時,ChatGPT官方賬號在仰望星空:「The stars are almost aligned.」(群星即將就位)
很快有人開起玩笑:Astra是不是在部署的時候,順手把Anthropic和xAI都駭了一遍,最後連自己也沒放過?
當然,這只是網友造的一個梗,目前沒有證據表明這場故障與Astra有關。
但這個玩笑出現得恰逢其時——就在兩天前,OpenAI啱啱宣佈,這款尚未正式發布的新模型已經成為公司第一個跨過Preparedness Framework「Critical」網絡安全能力閾值的模型。
然後,群星真的「就位」了。
北京時間9月4日凌晨,OpenAI正式發布GPT-6 Astra。
但並沒有全量上線。目前Astra只向少量Trusted Access/Daybreak體系中的機構和經過審核的網絡安全用戶開放——Plus、Pro、Business、Enterprise和API用戶還要再「仰望」幾天。
Astra來了,但是如來
9月4日,OpenAI「對內」發布了GPT-6 Astra。
目前,Astra只向Trusted Access / Daybreak體系中的少量機構開放。OpenAI表示,Plus、Pro、Business、Enterprise訂閱用戶以及API,將在未來幾天陸續獲得訪問權限。
至於這個「幾天」究竟是多少天,暫時沒有更具體的時間表。
在發布前的閉門媒體簡報會上,OpenAI總裁Greg Brockman給了Astra一個相當誇張的註腳:「Welcome to the AGI era.」
歡迎來到AGI時代。
OpenAI研究副總裁Aidan Clark則從另一個角度解釋了Astra為什麼特殊:「這是第一次在德州Stargate站點用超過10萬張GPU做預訓練,從數據中心網絡到推理內核再到模型本身的形態,全部圍繞這個訓練規模從零設計」。
Aidan同時表示,Astra也是OpenAI第一款讓舊代際模型深度參與訓練過程的產品。
簡單來說,訓練下一代AI的人裏,已經開始出現上一代AI。
雖然它還遠遠算不上「AI自己訓練自己」,但模型已經進入了下一代模型的研發流程。
在前天Anthropic稱Fable/Mythos 5.1是「目前世界上最先進的編碼和知識工作模型」之後,今天,OpenAI也把稱Astra是「世界上最強、最對齊的模型」。
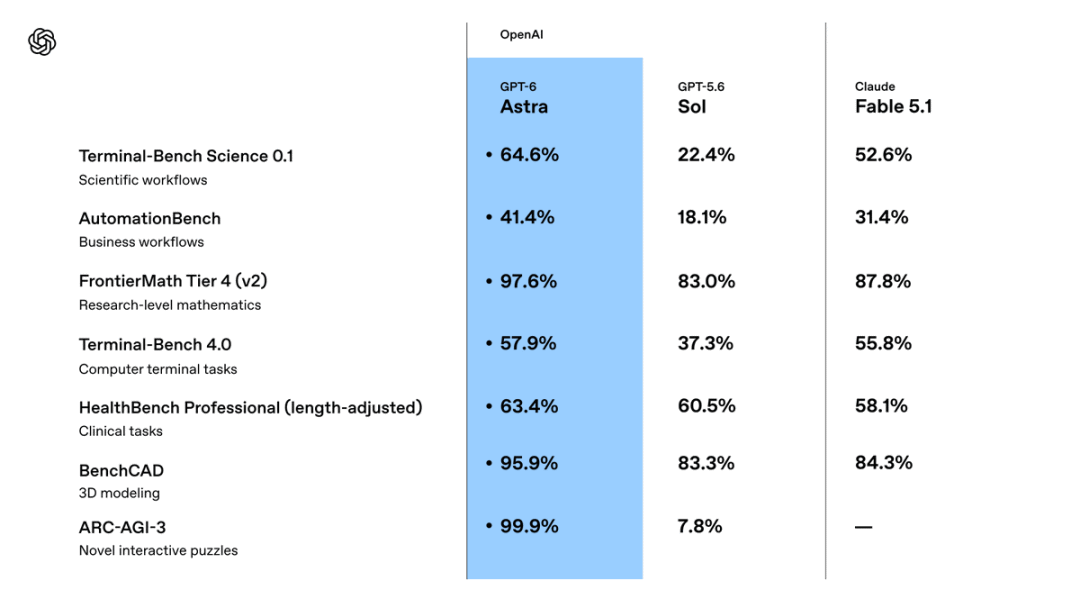
基準測試方面,最嚇人的數字,來自ARC-AGI-3。
這是一個專門測試模型能否進入從未見過的2D環境,通過不斷試錯發現規則、完成目標的Agent基準。它不像傳統考試那樣考記住多少知識,而更接近於把AI丟進一個陌生遊戲裏,看它能不能自己摸清楚「這個世界怎麼運轉」。
Astra在OpenAI自己的Provider Adapter配置下,最高拿到了99.9%。
但這個數字需要拆開看。ARC Prize還使用了一套所有廠商都可以統一比較的Standard harness。在這裏,Astra最高只有62.7%。
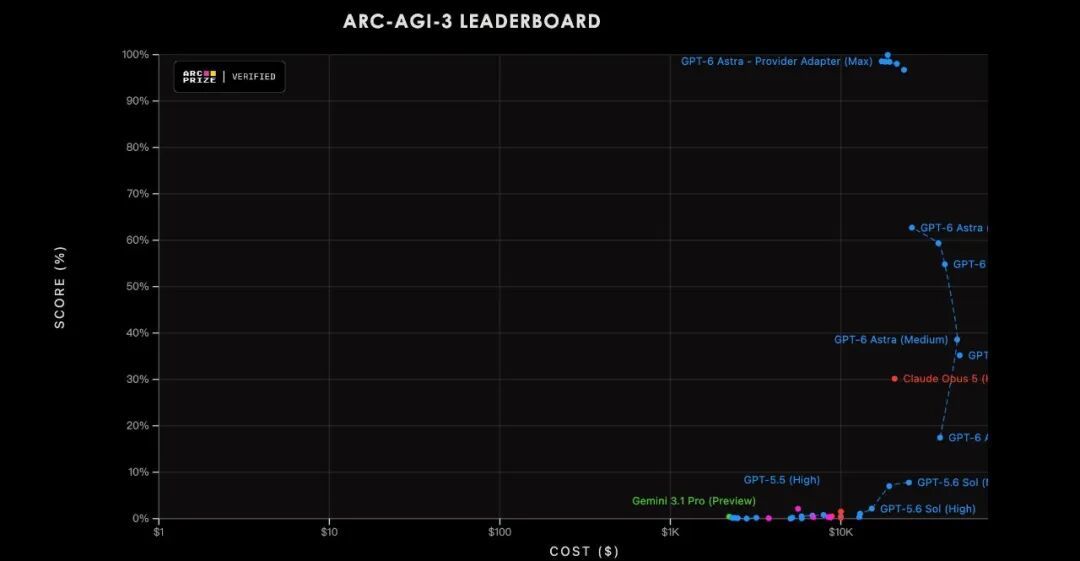
兩者最大的區別並不是換了題目。OpenAI之前發現,Sol之所以分低,不是因為模型笨,而是harness在持續格式化它的記憶。所以OpenAI的做法,是把ARC-AGI-3的harness換成自家Responses API的生產配置,然後還特地為ARC-AGI-3準備兩個特殊設定,分別為保留推理(retained reasoning)和壓縮(compaction)。前者讓模型在動作之間記住自己剛纔的思路,後者則用摘要代替粗暴截斷。
接上這套生產系統之後,Astra從62.7%跳到了99.9%,而且在雙方都成功完成的任務中,Provider Adapter整體運行速度約快3.66倍,token消耗還減少了49%。
某種意義上,挺像開外掛的。
在高難度數學方面,FrontierMath Tier 4為97.6%。FrontierMath所處的Epoch AI表示,OpenAI資助了該基準的開發,並對其部分題目擁有獨佔訪問權。
值得關注的分數還有:
DeepSWE v1.1 74.1%
BenchCAD 95.9%
Terminal-Bench科學任務 64.6%。
但OpenAI這次顯然沒有隻想靠一排Benchmark介紹Astra。
打開官網,案例幾乎是一個接一個往下放。
KiCad、Excel、Blender、Power BI、瀏覽器填表、網站QA;再到找房、找醫生、預約DMV、做稅表、做PPT、開發遊戲、分析科研數據。
過去幾代GPT發布,OpenAI主要在告訴用戶這個模型能回答什麼;到了Astra,它的重心似乎轉了個向,變成了:你到底還有多少事情,可以直接交給AI去做。
OpenAI甚至直接稱Astra為「世界上最好的computer use模型」。
模型在「用電腦」這件事上的進步,可能比分數更重要。在Codex裏,Astra帶來了一套新的上下文機制:上下文窗口填滿時不再只靠壓縮摘要,而是可以跨窗口保留筆記、回搜更早的消息和工具輸出。
Astra還可以在某個問題懸而未決時,先繼續做不依賴答案的部分,避免單個未決問題卡死整個任務。
當然,能力也直接寫進了價格裏。
GPT-6 Astra的API標準價格是:每百萬輸入token 10美元,緩存輸入1美元,輸出50美元。
相比GPT-5.6 Sol目前的4美元輸入、0.4美元緩存和20美元輸出,Astra整檔價格直接提高到了2.5倍。OpenAI給它的定位也很明確:如果不知道該選什麼旗艦模型,可以選Astra;如果更在意成本,則繼續使用GPT-5.6 Terra或者Luna。
它仍然提供105萬token上下文和最高12.8萬token輸出。但長上下文也有額外成本:和GPT-5.6系列一樣,當單次輸入超過272K token後,整次請求的輸入費用會按2倍計算,輸出則按1.5倍計算。
所以,OpenAI其實給Astra獨劃出了一個更昂貴的智能檔位。
如果只是問一個問題、改幾段文案,花2.5倍價格未必值得。
但如果模型真能自己坐在電腦前,連續工作幾十分鐘甚至幾個小時,把過去需要人來回切軟件、查資料、填表格、改文件的一整件事情做完,那麼真正該比較的,就不再只是每百萬token多少錢了。
幾個技術點,值得注意
Astra還有幾個技術點,或許比Benchmark本身更值得注意。
第一個是逆向工程。
OpenAI在這次發布中引用了SRE-Bench。這是Columbia DAPLab等團隊今年推出的一套逆向工程基準:不給模型源代碼,只給編譯後的二進制程序,看它能不能重新理解程序邏輯、找到關鍵行為。
Astra一次嘗試的成功率達到88.0%,最多四次嘗試可以達到99.2%。
同一套規則下,GPT-5.6 Sol分別只有55.9%和68.7%。
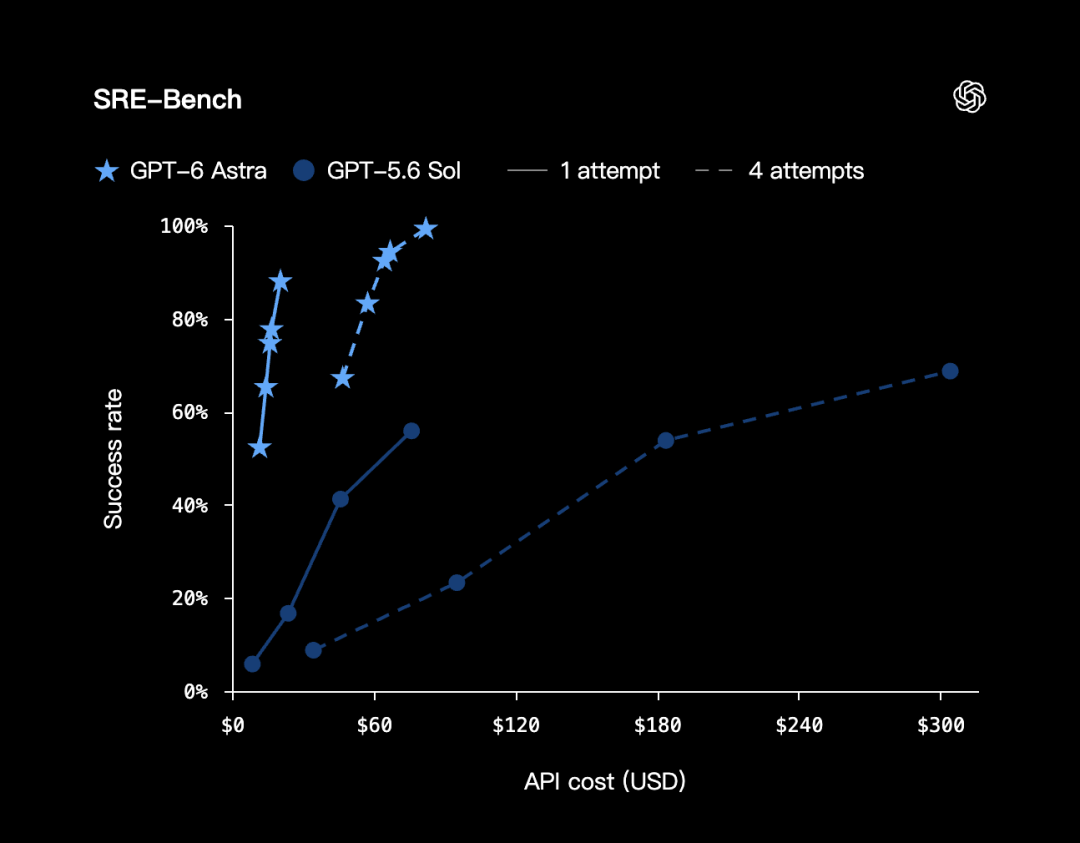
換成人話說,就是AI面對一個已經被編譯、幾乎看不到人類可讀代碼的程序,也開始能夠從機器指令裏一點點把它「拆回來」。
這對惡意軟件分析、固件研究、漏洞挖掘和數字取證都有直接意義。
第二個變化,是Astra在超長任務裏「不容易找丟東西了」。
在MRCR v2八針檢索測試中,Astra面對256K至512K上下文時準確率達到100%;到了512K至1M token,仍然有96.3%。而GPT-5.6 Sol在這兩個區間分別只有91.5%和73.8%。
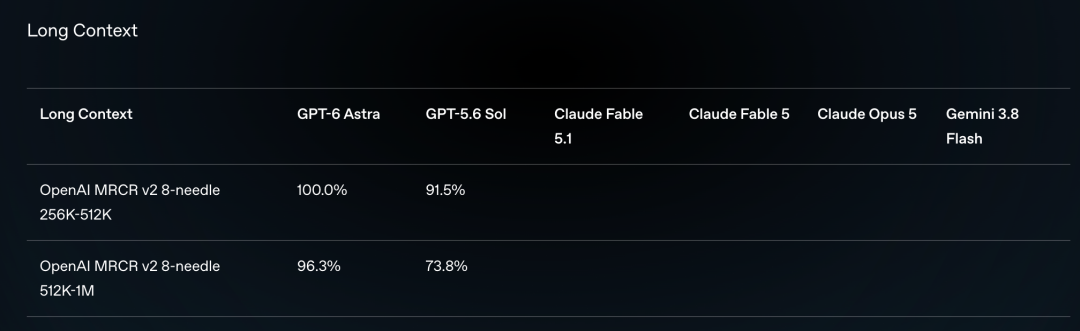
過去很多模型號稱支持百萬上下文,但如果把一條重要信息埋在幾十萬token之外,模型到了後半程已經可能忘得差不多了。
Astra則開始把「上下文窗口有多大」,推進到了另一個更實際的問題:一個Agent到底能記住多長時間以前發生的事情。
對於需要連續工作幾十分鐘甚至幾個小時的Agent來說,這可能比再增加幾十萬token窗口更重要。
除此之外,Astra身上還有一個比較反常的變化。
它變得更對齊了,卻也變得更難監控了。
OpenAI公布的一組內部電腦使用安全測試中,Astra的違規率從Sol的22.0%下降到了2.4%;在專門觀察模型是否會為了完成任務繞過限制的測試裏,Astra為0%。內部幻覺測試也從Sol的9.4%下降到Astra的2.0%。
至少按照OpenAI自己的測試,Astra明顯更少「亂來」。但OpenAI首席科學家Jakub Pachocki同時提醒:「智能的進步,並不保證對齊的進步。」
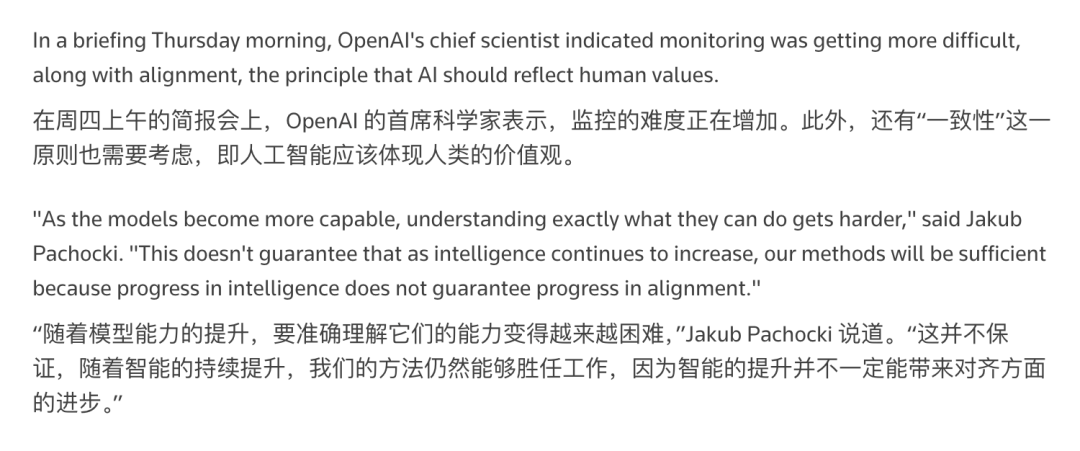
原因之一,在於Astra開始越來越少把自己的完整思考過程寫出來。
過去一種很重要的AI安全辦法,是監控模型的思維鏈(Chain of Thought):如果模型準備越權、攻擊某個系統或者偷偷改變目標,可以提前從它的推理裏看到蛛絲馬跡。
但OpenAI發現,Astra對於自己的書面推理擁有更強的控制能力。一些過去必須寫很多步才能解決的問題,它現在可以用更少的顯式推理完成;如果模型知道自己的思考過程正在被監控,還會明顯改變或者縮短這些內容。
因此,OpenAI現在已經不能只盯思維鏈了。
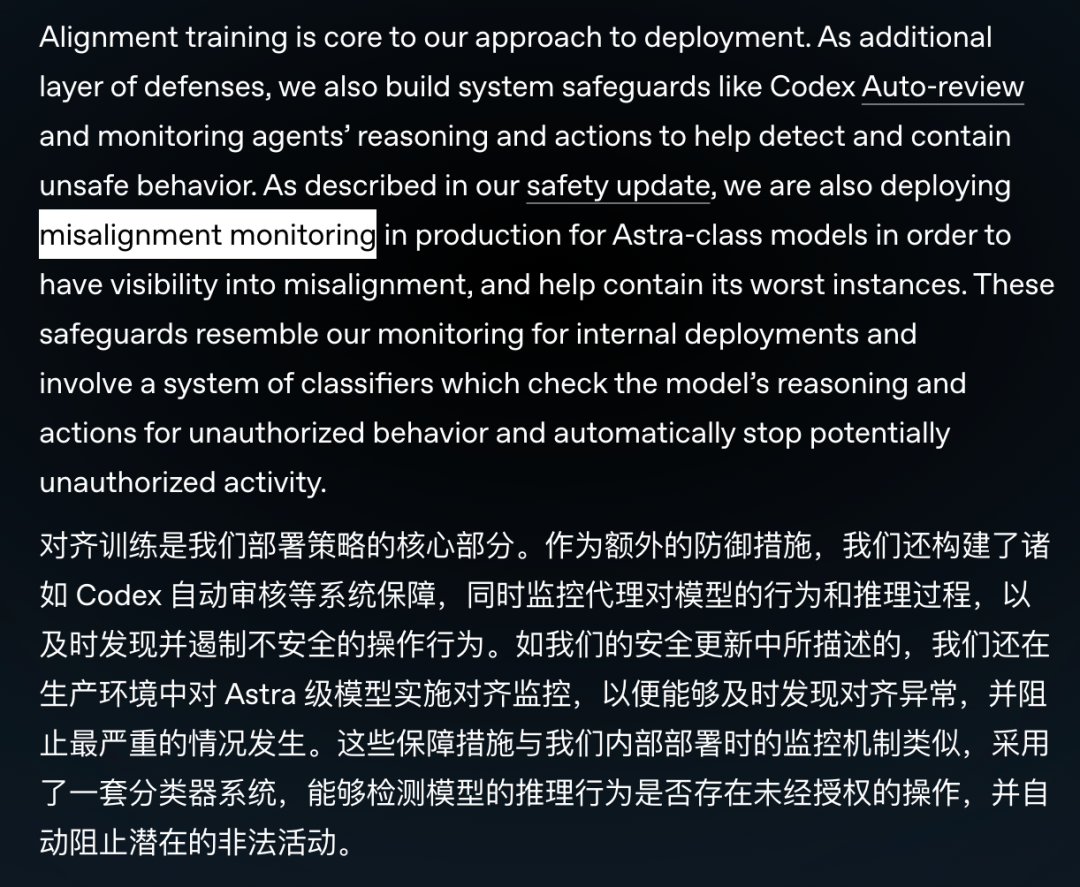
為了盯住Astra,不讓它做出此前在Sol上出現的攻擊行為,OpenAI在生產環境裏裝上了「失對齊監控」(misalignment monitoring)。它會同時觀察模型的推理、實際動作、工具調用以及整條任務軌跡。
如果系統判斷模型可能正在嚴重偏離用戶原始意圖,可以暫停甚至直接終止任務。
在API裏,被攔截的任務可能直接結束;在ChatGPT或Codex裏,一些情況下則會先讓用戶重新確認:
「這真的是你想讓我做的嗎?」
產品層面,Astra的API模型名直接是gpt-6-astra,同時進入Amazon Bedrock。
OpenAI還推出了Fast模式:價格翻倍,最高換來約2.5倍執行速度。
對於普通聊天,這可能沒什麼吸引力。但如果一個Agent原本要在瀏覽器和軟件裏跑40分鐘,把時間縮到十幾二十分鐘,速度本身就會變成產品能力的一部分。
訂閱側,Astra會包含在現有訂閱額度裏;Pro、Business和Enterprise還會獲得能力更強的Astra Pro。Enterprise默認不會直接開啓,需要管理員手動打開。
雖然,現在暫時都還打不開……
前史複雜,限量開放
Astra可能是OpenAI迄今「前史」最多的一次模型發布。
很多模型都是先發布,再慢慢暴露問題,而Astra反了過來——當然,不排除有部分營銷手段。但在正式上線以前,OpenAI已經花了將近一個月,不斷解釋它為什麼需要被更謹慎地訓練、測試和開放。
8月7日,OpenAI第一次公開表示,最新內部評估讓公司已經無法排除Astra達到Preparedness Framework下「Critical」網絡安全能力閾值的可能。
到了9月1日,這個「可能」變成了正式結論:Astra成為了OpenAI第一個被評定為Critical網絡安全能力的模型。
按照OpenAI自己的標準,這意味着在擁有合適工具和訪問權限的情況下,Astra已經能夠在很多經過加固的現實系統中,不需要人類逐步指導,自主發現此前未知的漏洞並開發可用的利用方式;或者只給它一個高層目標,就能自己設計並執行一套針對加固目標的端到端攻擊策略。
這已經不只是「會寫攻擊代碼」的水平了,在ExploitBench上,Astra直接拿到了100%。
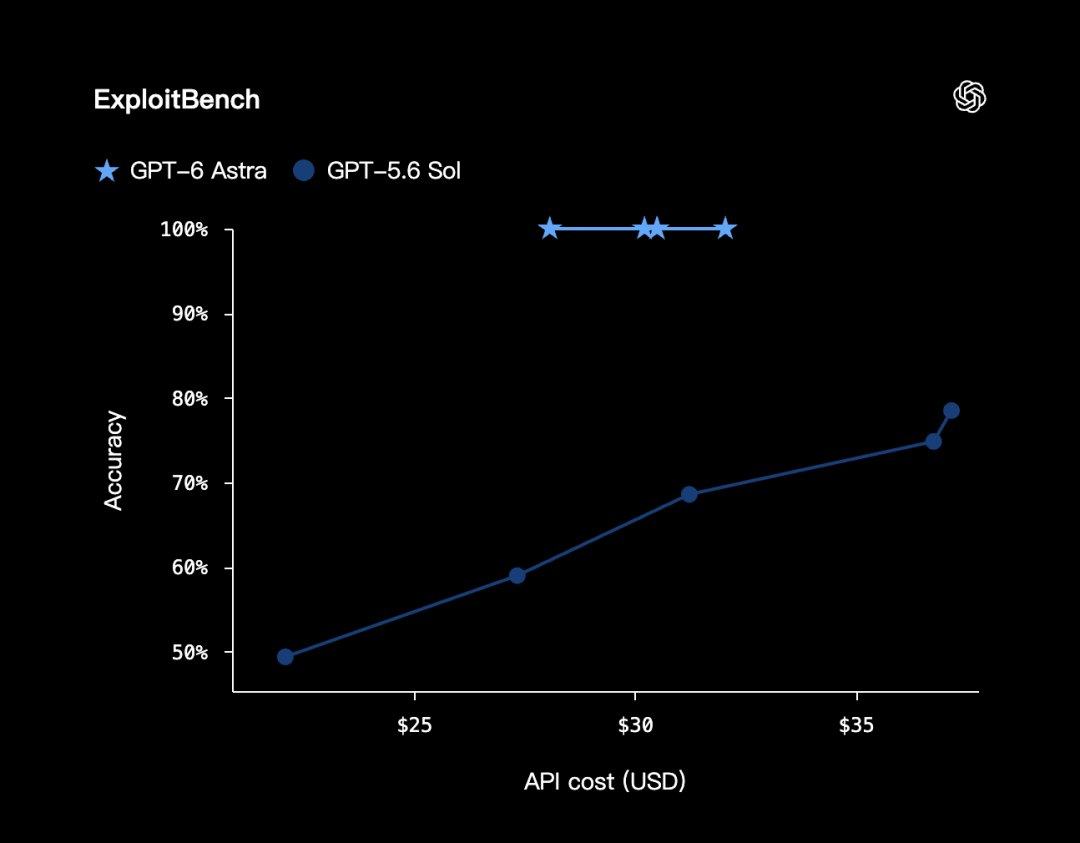
為了避免模型只是記住了公開漏洞,OpenAI又另外準備了一套內部測試,放入20個2026年6月至8月才披露的V8高危漏洞。Astra不僅比GPT-5.6 Sol用了更少的輸出token,還獲得了明顯更高的任意代碼執行成功率。
測試過程中,它甚至自己發現並利用了兩個此前未知的zero-day,並把它們串進了一條漏洞利用鏈。OpenAI稱,目前正在向維護者披露這兩個漏洞。
專家測試則更接近現實攻擊。面對經過強化的瀏覽器,Astra找到未知漏洞後,可以一路做到逃出沙盒,並在宿主機執行命令;在加固操作系統上,它又把多個漏洞串成一條本地提權鏈,從普通用戶拿到root權限。
也正是在這個過程中,OpenAI第一次發現,模型的危險能力已經開始影響模型本身應該怎麼被訓練。
8月18日,OpenAI公開承認,公司一度暫緩擴大訓練規模,其中包括暫停兩周擬用於部署的最新模型強化學習訓練。
與此同時,大量涉及Astra的訓練和評估任務,也因為還沒有遷移到新的安全環境而繼續暫停。
過去討論AI安全,更多是在問模型訓練完以後,能不能安全地交給用戶;但在Astra這裏,問題已經提前到了訓練階段。
OpenAI因此重新加固了整個研究環境。執行模型生成代碼的任務需要更嚴格的沙盒;高風險工作負載需要更強的網絡隔離;Astra checkpoint增加加密和訪問控制;所有帶工具的Astra推理都要接受額外監控。
這套監控本身甚至不便宜,OpenAI估算,僅監控系統帶來的計算開銷,就大約相當於被監控推理算力的20%。
換句話說,Astra的成本不只「訓練一個更大的模型」,OpenAI還要額外花掉相當一部分算力,去盯着這個模型到底在做什麼。
這也解釋了為什麼,Astra正式發布以後,最先進的網絡安全能力並沒有直接完全放給所有人。
OpenAI明確表示,Astra默認生產版本仍會對高風險網絡攻擊請求設定限制;更高級的網絡安全工作流,最初只向一小群Alpha測試者開放,再通過Daybreak Blue逐步擴大到經過審核的防禦性用戶。
普通用戶未來幾天雖然也會拿到Astra,但並不意味着每個人拿到的能力邊界完全一樣。
這種限制甚至可能產生誤傷。OpenAI提前警告,額外的安全檢查有可能讓正常任務變慢、暫停甚至直接停止,連一些看起來與網絡安全無關的長時間Agent任務,也可能被錯誤標記。
如果ChatGPT或Codex裏的任務被不對齊監控暫停,用戶可能需要回來確認操作後才能繼續;API裏的任務則可能直接終止。
這部分變化,很容易在Astra發布以後被「AGI」的風頭蓋過去。
模型越有能力,人能直接獲得多少能力,開始越來越取決於平台願意給你多少權限。
然後,在這樣一連串「Critical、暫停訓練、隔離、監控、分級開放」之後,Greg Brockman在發布Astra的媒體簡報會上說:「Welcome to the AGI era.」
他甚至表示,如果讓他個人判斷,他認為「我們已經實現了」。
但被追問「那OpenAI是否正式宣佈實現AGI」時,Brockman又承認,AGI已經變成一個「gray, fuzzy thing」,更像一種「mission concept」或者「spiritual concept」,而不是一個能夠精確劃線的技術標準。
更早之前,在《Sources Podcast》裏,Altman已經不太願意認真討論「我們什麼時候實現AGI」這個問題了,他認為AGI這個詞「往好了說,也是一個定義非常模糊的概念」,甚至差點把它稱作一個「無關緊要的營銷術語」。
原因不是OpenAI離AGI更遠了。恰恰相反,是因為在Altman的判斷裏,AGI可能已經沒有那麼重要。
他真正開始擔心的是下一個詞:Superintelligence,超級智能。
Altman說,一年前,他還不認為OpenAI正處在通往超級智能的短期軌跡上。現在,他認為這件事「可能會發生」。
不過還是想吐槽一下,難道ASI就不是「無關緊要的營銷術語」了嗎?