語音轉寫正變成AI系統的實時感知層。
編譯 | ZeR0
編輯 | 漠影
智東西9月2日報道,今日,Meta推出由Meta超級智能實驗室開發的首個實時音頻感知模型Muse Voice Transcribe。
該模型提供實時流式自動語音識別(ASR)、支持超過20位說話人的語音分割以及端點控制功能,支持多語言,能處理超過1小時的長音頻,可實現無縫語碼切換,並通過語言、關鍵詞和上下文偏好來提高識別準確率。
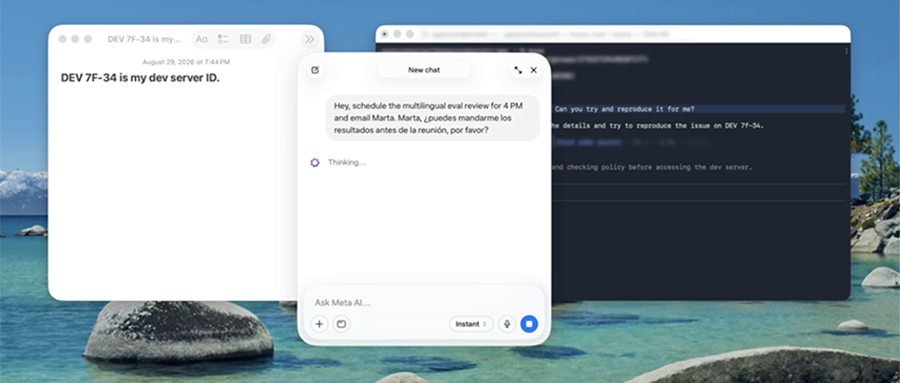
從示例來看,無論是講中文、中式英語口音,還是中英文混合表達,這款模型的轉寫速度和效果都相當不錯。