金磊 發自 凹非寺
量子位 | 公衆號 QbitAI
這個世界模型,着實是有點「反骨」在身上——
上崗前花了大把時間陪機器人訓練,等機器人真要開始幹活了,它卻先從部署鏈路裏退了出去。
要知道,以前的世界模型對機器人來說,就像是一個隨身攜帶的「腦內沙盤」,機器人先借助它預測未來會發生什麼,再據此決定下一步怎麼動。模型想得越多,推理鏈路往往也越長。
但這個「反骨」世界模型,卻把思路給換了一下。
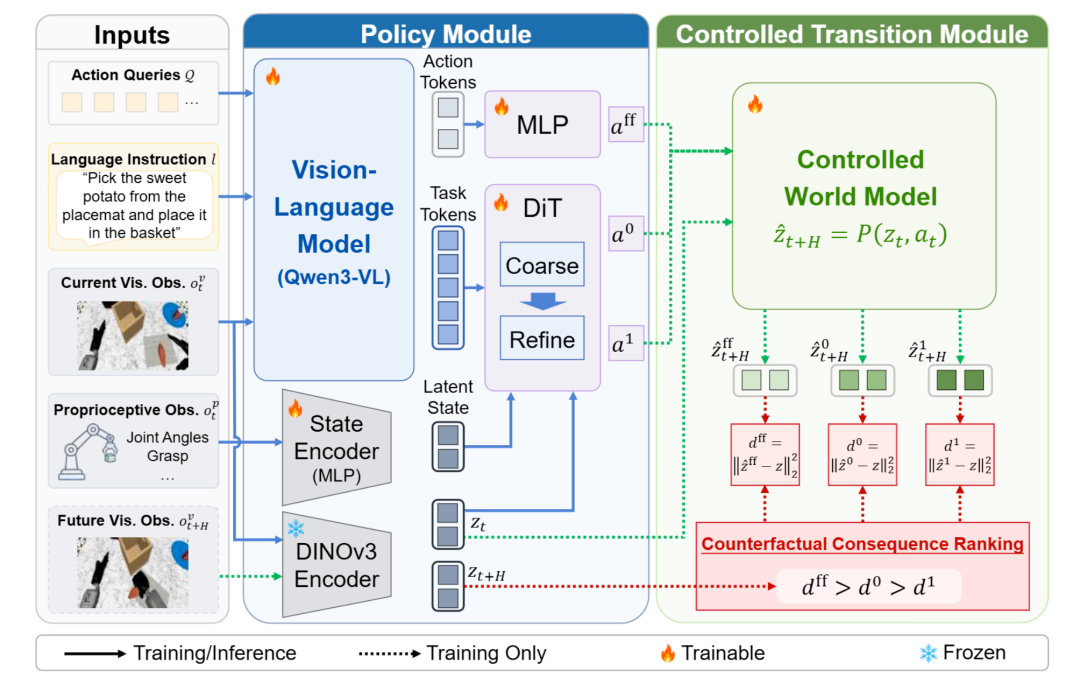
它只停留在訓練場裏,專門檢查機器人自己提出的動作會造成什麼後果,再把這種檢查變成策略優化的反饋。等訓練完成,受控世界模型便退出部署鏈路,機器人執行任務時無需繼續展開未來、搜索候選動作。
結果呢?
機器人反倒是更能幹活了!
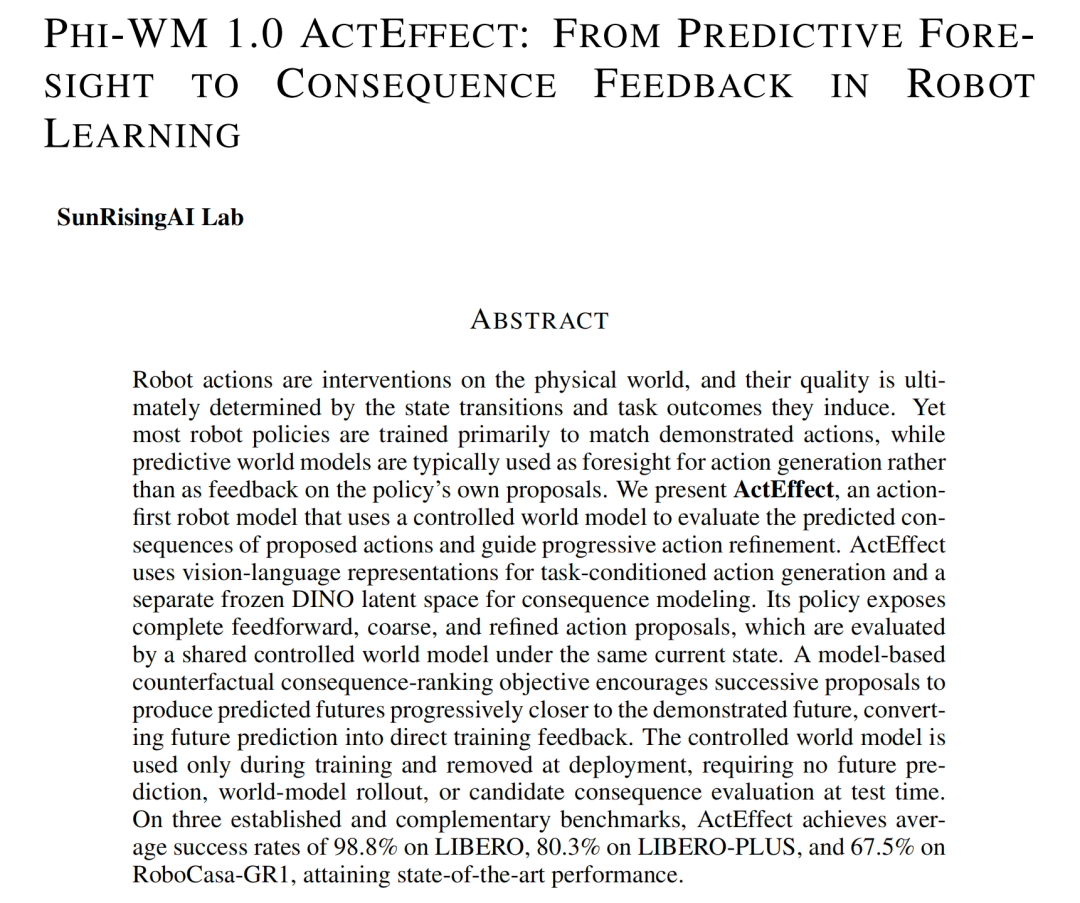
這便是由光象科技聯合清華大學李升波教授課題組發布的第一代物理原生世界模型Phi-WM 1.0 ActEffect(下文簡稱ActEffect),整體來看,這項技術試圖回答的是具身智能裏一個長期存在的問題:
機器人從演示數據裏學會了動作長什麼樣,能否進一步利用動作可能造成的後果,反過來改善自己的策略?
畢竟這個問題最終也會落到真實部署上。工業機器人每多運行一步模型,都對應新的時延、算力和成本。世界模型如果能在訓練時發揮作用,並在執行階段保持輕量,技術價值纔有機會繼續轉化為部署價值。
從測試結果來看,答案也是比較明確的。
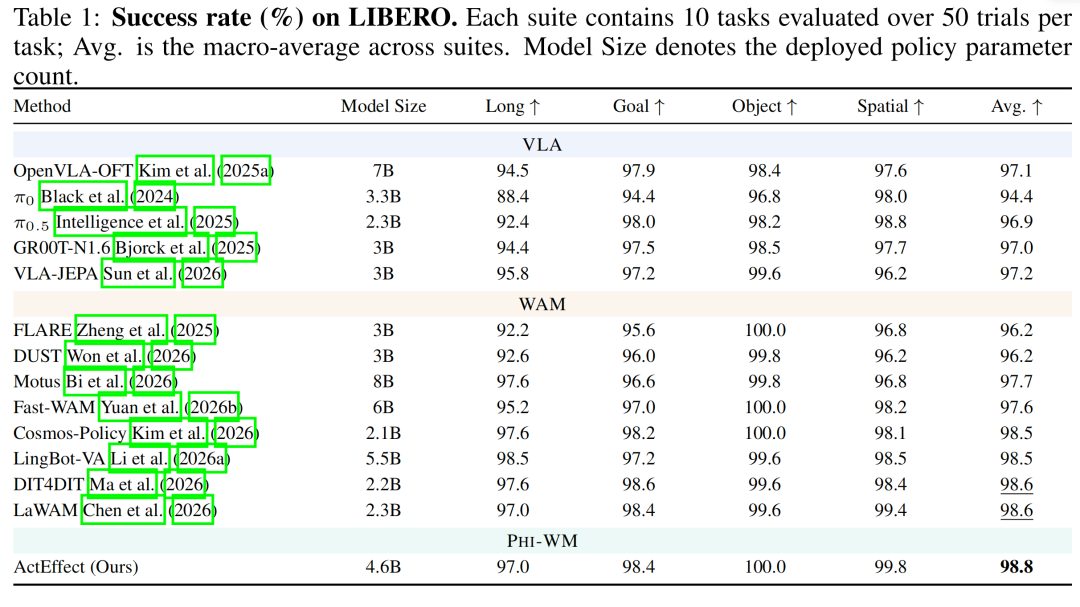
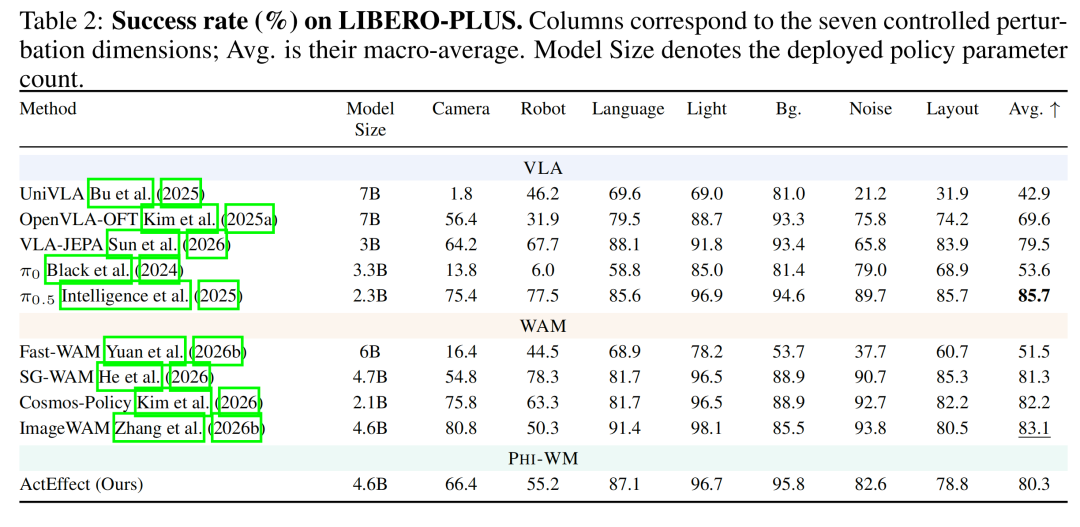
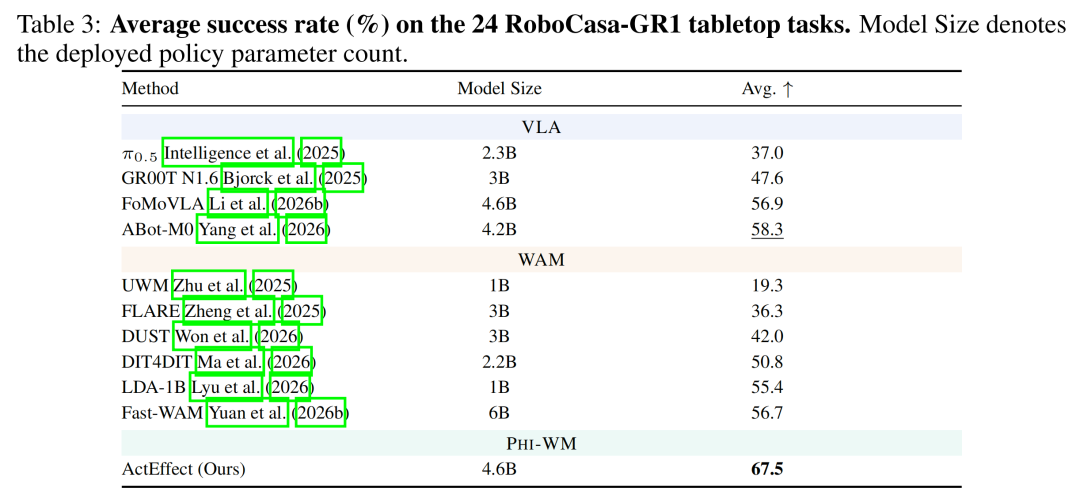
這項工作在LIBERO上取得98.8%的平均成功率,在加入七類分佈偏移的LIBERO-PLUS上達到80.3%,面對29維動作空間的RoboCasa-GR1,平均成功率為67.5%。
那麼如此「反骨」的方法,具體又是怎麼實現的?
我們這就深入了解一波。
先讓機器人交出三版答案
ActEffect的突破口,其實藏在機器人最熟悉的模仿學習裏。
目前很多通用機器人策略都建立在VLA之上。攝像頭負責告訴機器人眼前有什麼,語言指令交代任務,模型再照着演示數據生成動作。訓練時,自己的答案和示範動作越接近,通常就會得到越高的分數。
可到了物理世界,動作接近和結果正確之間,還是有明顯的差距的。
例如夾爪早合上一點,零件可能就沒抓穩;手腕角度稍微偏一點,原本順滑的插接便會卡住。兩段動作在數值上看着差不多,落到機械臂上,結局可能完全不同。
所以,ActEffect沒有急着給機器人接上一條更長的思考鏈,而是先讓策略把三版答案都交出來:
第一版來自前饋分支,像是機器人的「第一反應」;
第二版是MIP動作頭給出的粗提案;
第三版在粗提案上繼續精修,生成最終會被執行的動作。
這個過程的關鍵就在「完整」兩個字。因為擴散、流匹配一類策略在訓練中會經過不少帶噪的中間狀態,很難把每一步都當成可執行動作送進世界模型。所以ActEffect選出的三份提案則各自完整,放在同一個起點下,誰會帶來更好的後果,也就有了比較的基礎。
接下來,受控世界模型登場。
它拿到當前的視覺狀態和一份動作提案,隨後預測這段動作執行下去,場景會發生什麼變化。三份動作要分別走一遍,等於讓機器人在訓練場裏提前看了三次結果。
這裏還有一個頗有意思的處理。語言指令繼續留在VLA策略一側,負責告訴機器人要做什麼;受控世界模型只看當前畫面和動作,不再讀取任務語言。
例如同樣伸手推一下杯子,杯子如何移動,取決於它現在的位置、周圍環境以及機械臂施加的動作。至於指令寫的是「挪開杯子」還是「清理桌面」,並不會改寫這次推動產生的物理變化。
除此之外,ActEffect還把未來狀態放進凍結的DINOv3視覺特徵空間。它不用費力生成一張逼真的未來畫面,只需抓住物體位置、姿態和場景結構如何變化。所謂「物理原生」,落點也正在這裏。任務語義仍由VLA處理,動作帶來的狀態變化則被單獨拎出來學習。
不過,看過三版結果還不夠的,還有一個重要的關鍵環節,是把差別傳回策略。
訓練數據裏本來就有動作執行後的真實觀測。受控世界模型會把三次預測與這個真實未來逐一比較,要求精提案比粗提案更接近,粗提案又要勝過第一版前饋提案。
於是,策略每改一次動作,都能知道這次修改究竟有沒有把結果往正確方向推。
為了避免模型鑽空子,ActEffect還給排序損失加上了梯度截斷。差答案不能靠變得更差來襯托好答案,訓練只能繼續推動更好的提案靠近真實未來。
通過反饋信號進行學習,世界模型對「後果」的判斷被寫進策略權重。到了機器人上崗那一刻,受控世界模型和未來觀測分支會一起拿掉,只留下MIP動作頭完成粗提案和精修。
在了解完方法之後,接下來我們就得看它有沒有真把機器人教會。
先來看下LIBERO。這個基準包含四組單臂、多任務桌面操作,ActEffect在此拿到了98.8%,比DiT4DiT的98.6%高出0.2個百分點。雖然領先不算大,但更值得看的信息是引入後果反饋之後,機器人原有的基礎操作能力沒有被練丟。
再來看加大難度後的LIBERO-PLUS。
這套測試會改相機視角、機器人初始狀態和語言表述,還會在光照、背景、傳感器噪聲、物體佈局上製造變化。ActEffect的平均成功率為80.3%,相比Fast-WAM的51.5%高出不少。
到了RoboCasa-GR1,任務又不一樣了。模型要控制擁有雙臂、靈巧手和腰部自由度的GR-1人形機器人,在29維動作空間裏完成24項桌面操作。
ActEffect的平均成功率達到67.5%,比表中第二名ABot-M0高9.2個百分點,比Fast-WAM高10.8個百分點。動作維度更高、身體結構更復雜,後果反饋的作用也變得更明顯。
消融實驗則是把這套方法擰開來看了一遍。
去掉後果反饋,LIBERO平均成功率從98.8%降到97.0%;把DINOv3特徵空間換成VLM表示,成績來到97.3%;拿掉排序損失後,則回落到98.1%。
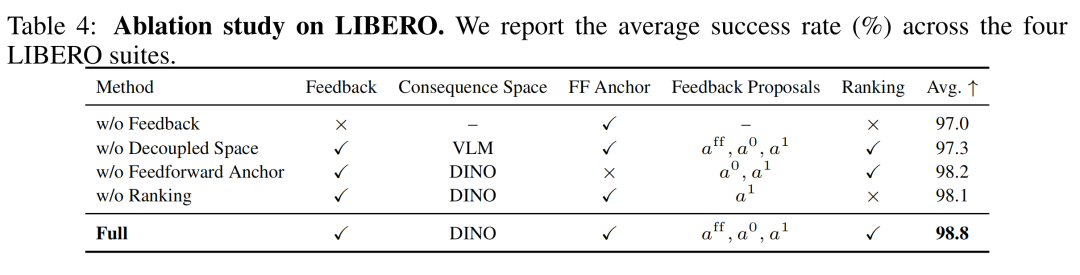
從這幾組實驗結果來看,ActEffect確實證明了這套訓練方式的有效性。
為什麼這種用法會與工業部署發生關係?
說到這裏,受控世界模型為什麼非得「退場」,也有了一個更現實的答案。
在實驗室裏看具身智能,我們的評價維度基本上就是任務成功率。但一旦進入到真實生產環境,這個維度就大變樣了。
因為機器人在仿真環境裏多跑一層模型,最後可能只是表格裏的一項計算開銷。而把同樣的鏈路搬進汽車工廠,每一次推理都會進入產線的賬本。
不僅如此,算力也會隨着規模被放大。單台機器人每一步多做一次未來展開,看起來尚能接受。等方案複製到幾十個工位、幾百台設備,額外的顯卡、功耗和維護都會變成實打實的成本。
而ActEffect把受控世界模型留在訓練階段,正好避開了這部分在線開銷。它想從現有演示數據中再榨出一層監督,讓機器人提前喫到「後果」的經驗,上崗後又不必揹着整套世界模型繼續往前跑。
換句話說,它把「多想一會兒」留給了訓練,把更短的鏈路留給了執行。
而光象科技選擇這樣的技術路線,也與它正在進入的場景有關。
汽車製造裏有大量散亂件上下料、複雜曲面質檢等任務。傳統自動化設備往往圍繞固定工位開發,一套夾具、一段軌跡服務一種零件。零件位置發生變化,或操作空間變得狹窄,原本穩定的流程就可能卡住。具身智能想補上的,正是這一段適應能力。
目前,光象科技已經圍繞焊接上下料、移動質檢等典型高價值工位完成真實場景驗證,並與多家國內外頭部汽車企業展開商業合作。在2026ATC展會上,團隊把Phi-Bot X1放進了蔚來汽車焊接上下料場景,機器人連續運行3天,累計作業21.5小時,期間零失誤、零中斷。
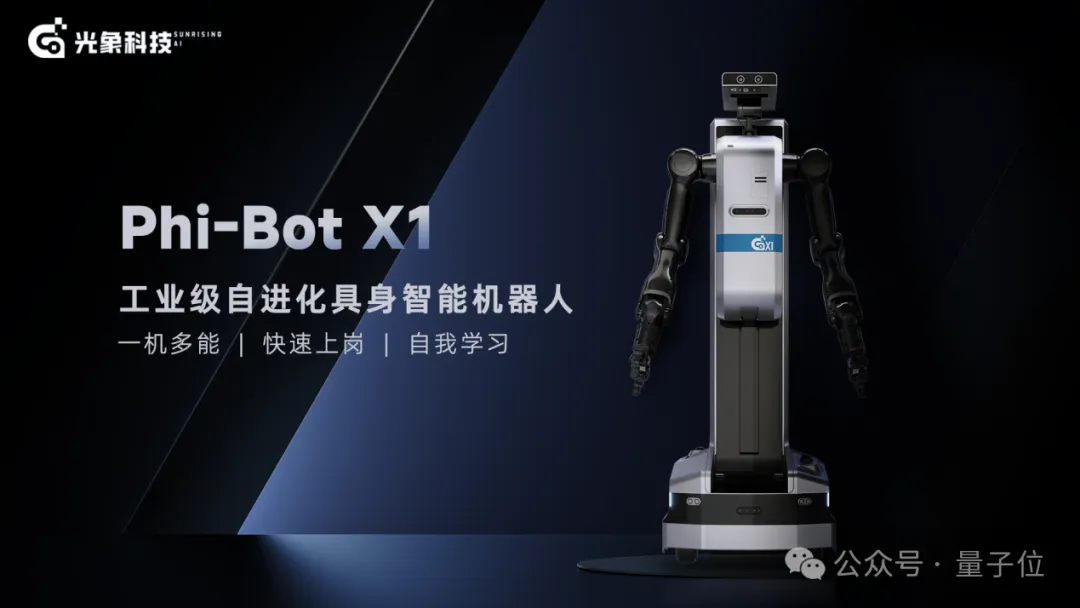
眼下,ActEffect已經在三項仿真基準上跑通了訓練方法。真機這一棒,光象科技手裏已有Phi-Bot X1接着往下跑。21.5小時的記錄來自整套工業具身系統,下一步才輪到新模型沿着這條真實鏈路繼續接受驗證。
好在,光象科技並不缺少汽車產業裏的工程經驗。
光象科技成立於2025年4月,由清華大學車輛與運載學院和人工智能學院聯合孵化。創始人兼CEO張濤是清華大學博士、米蘭理工大學博士後,此前擔任阿里巴巴高德地圖技術總監和空間感知引擎負責人,相關技術曾進入汽車量產體系。聯合創始人李升波長期從事自動駕駛與具身智能研究,也有多項技術進入產業應用。
因此,這家公司一邊做強化學習和世界模型,一邊也在搭機器人本體、數據算法體系和開發平台。進入工廠以後,模型只是整套系統中的一環。硬件要扛得住連續運行,系統得方便部署,出了問題還要能迅速維護。缺了任何一塊,算法成績都很難完整落到產線上。
具身智能的分野,最終會落在商業化能力上
過去兩年,具身智能最不缺令人驚豔的演示。
機器人會跑、會跳、會疊衣服,也能聽懂一長串指令。可到了客戶現場,演示視頻裏的幾十秒,很快就會被拉長成一天、一個月,甚至一整年的連續運行。
當然,工廠也不會因為一項基準成績就簽字驗收。交付以後,少成功一次,都可能變成停線和維修工單。具身智能公司的差距,也會在這個過程中慢慢拉開。
機器人先要在約定時間裏完成正式交付,隨後是節拍、精度、安全性、故障率等一項項驗收指標。過了這一關,同樣的能力還得從一個工位遷移到相似工位,從一家工廠複製到更多工廠。
複製得越多,另一個問題也隨之而來:每換一個客戶,方案需要重新定製多少?部署要花多長時間?機器人和算力的投入,能否被節省下來的人力與停線損失覆蓋?
這也是ActEffect把世界模型留在訓練場的商業意味。
如果後果反饋能讓策略在真機上更穩,又能省掉執行階段的世界模型開銷,那麼機器人複製到更多工位時,算力成本不會跟着推理鏈路一起膨脹。對於一套準備規模部署的工業系統,這比單次演示裏多完成一個動作更實在。
只是這條推論,目前還差真機數據來補上最後一段。光象科技現階段已經完成一部分真實場景驗證,並與頭部車企達成商業合作。它選擇的工位有明確需求,團隊也兼具學術研究和汽車產業經驗,這些條件讓它有機會繼續向交付環節推進。
驗收和複製仍要一關關過。Phi-Bot X1在真實產線上復現驗證中的穩定表現,同一套能力複用到新的車型、零件和工位,部署與運維成本持續壓低,將讓這些合作走得更遠。
ActEffect同樣要接受這張考卷。它已經在仿真裏證明,世界模型未必需要一直跟着機器人,讓它在訓練階段反覆檢查動作後果,也能把經驗留給策略。這給世界模型進入具身智能提供了另一種位置安排,也碰到了工業部署最現實的兩件事——穩定性和成本。
再往後,VLA、WAM等技術邊界還會繼續變化,各種方案也會互相吸收。對客戶來說,這些縮寫終究只是手段。客戶是否願意驗收,方案能否快速複製,賬能不能算得過來,都會給出更直接的答案。
ActEffect這個有些「反骨」的世界模型,它已經在訓練場裏完成了第一輪工作。
未來,在產線上頂住節拍、誤差和一天天的連續運行,纔是更難的一場考試。