傳統編程,真要終結了?
11天,6778次提交,超過100萬行新代碼。全程Token燒掉約16.5萬美元。
最近Bun 1.4正式發布,直接把Bun的大量底層代碼,從Zig重寫成Rust。
GitHub上的合併記錄顯示,一次改動就達到「+1,009,257行、-4,024行」。
誇張的是,這100萬行代碼,並不是幾百個程序員一點點敲出來的。
主導整個項目的核心開發者Jarred Sumner,先搭了一套Agent工作框架,然後放AI進去並行重寫。
11天后,主體工程基本成型。
隨後幾個月,Agent繼續改Bug、跑測試、反覆打磨。
直到今天,這套代碼跟着Bun 1.4正式發布,跑在了數百萬開發者的電腦上。
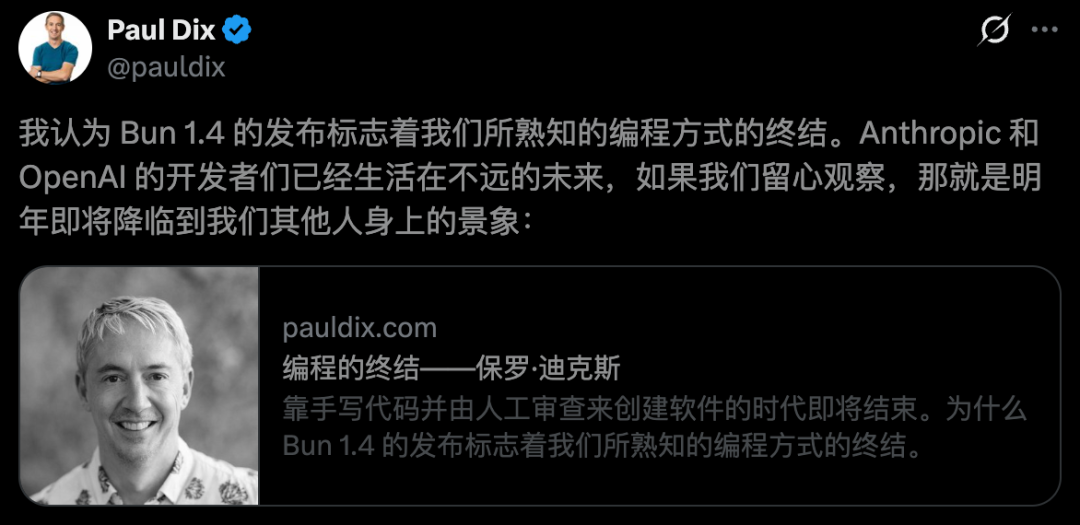
InfluxDB創始人Paul Dix看完後,直接寫了一篇文章:《The end of programming》。
他直接下判斷,我們熟悉的那種「程序員親自寫代碼,再讓另一個程序員逐行Review」的軟件開發方式,正在走向消亡。
100萬行代碼
人類根本看不過來了
Paul Dix真正被震到的,這100萬行代碼,多到人已經看不過來了。
如果一個開發者一周只能交幾個PR,那當然可以認真Review。
但他觀察到,OpenAI和Anthropic內部一些開發者,現在一周能交幾十甚至上百個PR。
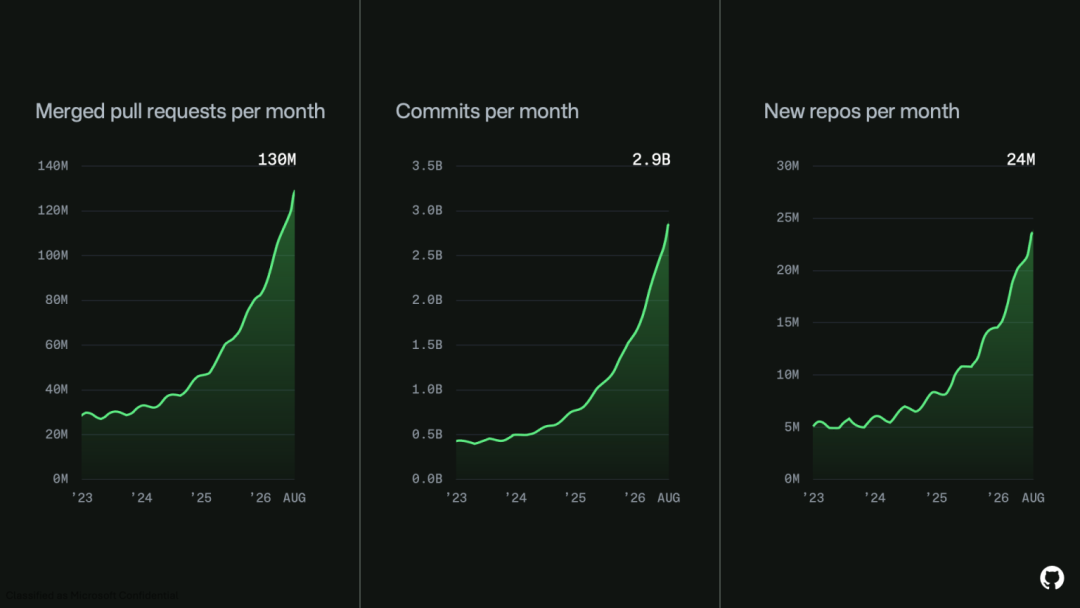
到了這個量,逐行看代碼基本就成了不可能完成的任務。
他們的工作方式已經開始變了。
寫Prompt、搭Harness、做測試、設驗證條件,然後把Agent放進去循環。
代碼讓機器自己產,人盯結果。Bun 1.4就是這套打法一個很極端的案例。
Jarred沒有親手把100萬行Rust敲出來。
他乾的活更像搭流水線:先告訴Agent應該怎麼遷移,什麼結果算正確,再讓多個Agent並行推進。
第一版出來後也沒有結束,接着繼續跑、繼續測、繼續修。
所以Paul Dix覺得,很多人說「這不就是把Zig翻譯成Rust嗎」,多少低估了這件事。
翻譯出100萬行代碼不稀奇。
能把這100萬行代碼一路修到穩定發布,纔是關鍵。
A社和OpenAI員工
已經活在「一年後」
Paul Dix還有一個很有意思的判斷。
A社和OpenAI的開發者,現在其實活在「普通程序員一兩年後的世界」。
他們能用最新模型,而且Token幾乎管夠。
普通開發者還在算每周額度,他們已經可以讓最強模型一天到晚在後台狂跑。
Bun這次重寫,相當於把這種工作方式提前公開演示了一遍:
一個足夠聰明的模型,加近乎不限量Token,再加一套靠譜的Harness,到底能把軟件生產速度推到什麼程度。
當然,人類手寫代碼不會明天就沒了。
大公司流程、責任制度、安全審查,都會讓老辦法繼續存在很多年。
Paul Dix自己也認為,傳統編程方式可能還會拖上十年。
但最快的那批人,已經不太像傳統程序員了。
他們開始決定需求、拆任務、搭Agent流水線、做驗收。
至於下面到底生成了5000行、5萬行還是100萬行代碼,可能都不會親眼讀完。
真正值錢的,從代碼變成驗證
AI生成代碼越多,並不意味着軟件天然越好。
恰恰相反。未來一定會出現海量Bug、垃圾代碼,以及沒人願意維護的軟件。
Paul Dix自己也承認這一點。真正變化的是,生產軟件的方法。
以前,代碼本身就是核心資產。
未來,大量代碼可能從出生到上線,根本沒有任何一個人類完整讀過。
人類真正需要死死抓住的,是系統行為、測試結果、性能指標、安全邊界和用戶體驗。
代碼從「作品」,變成了機器自動生成的中間產物。這也解釋了為什麼Harness突然變得如此重要。
100萬行Rust,可能只是個開始。
以後最值錢的程序員,未必是敲代碼最快的人。可能是那個最會讓一群AI幹活的人。