前些天,號稱實現 AGI的 GPT-6 Astra 發布後,引發了全網對於遞歸自我改進架構的熱議。
AI 已經開始參與下一代 AI 的研發。問題是,這種事情到底已經發生到什麼程度了?
就在啱啱,OpenAI 公開了 AI 模型在自家內部加速科研的詳細數據。
此外,OpenAI 正式宣佈已達成自動化 AI 研究實習生的目標,並在 2028 年實現完全自動化的 AI 研究人員。
作者表示,遞歸式自我改進可能是未來幾年 AI 能力發展最重要的推動因素,但它默認只會發生在少數前沿 AI 實驗室內部。保持透明比以往任何時候都更迫切,這樣我們才能為公衆討論模型開發的速度和時機提供信息。我呼籲其他 AI 公司也這樣做。
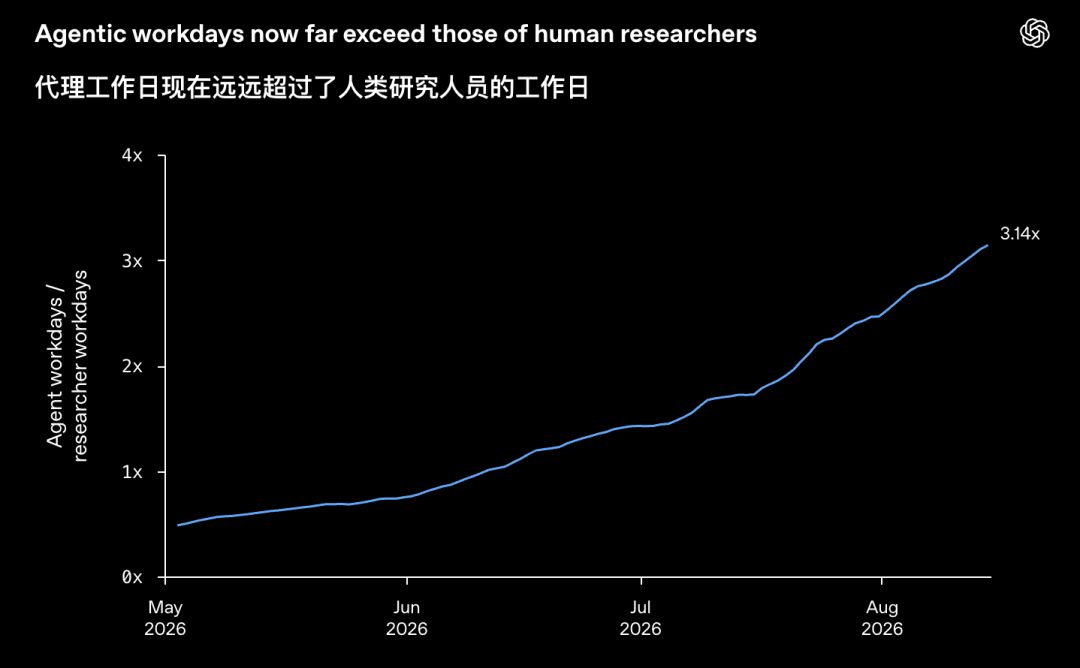
已經公開的內部數據顯示:截至 2026 年 8 月中旬,OpenAI 研究部門中,每 1 個人類工作日對應 3.1 個 AI Agent 工作日在同步運轉。
也就是說,每位 OpenAI 研究員身邊,已經站着 3 個 AI 同事。
更關鍵的是,Agent 不只在補代碼。它正在進入實驗運行、技術支持、結果分析和監控等更多環節。
AI 幫人類造出更強 AI的閉環,已經從概念討論走進實驗室日常。
博客鏈接:https://openai.com/index/research-acceleration-view-inside-openai/
AI 正在接管研究循環裏的體力活
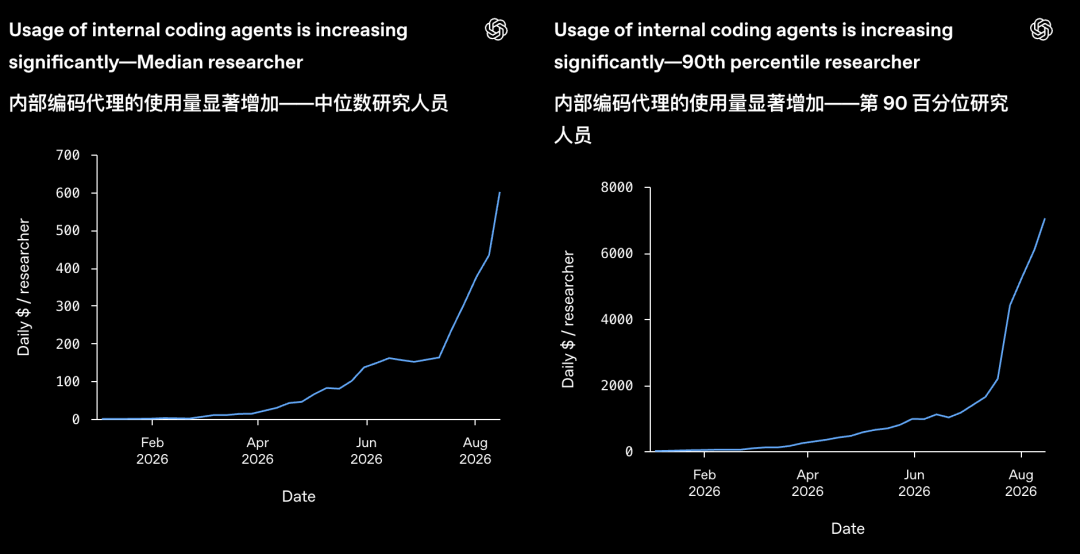
2026 年初,OpenAI 中位數研究員的 Agent 用量還相當有限。
到了 8 月中旬,中位數研究員每天消耗的推理 token 摺合約 600 美元(按 API 價格計算);排在第 90 百分位的重度用戶,這個數字超過 7000 美元 / 天。在 2026 年 6 月之前,整個研究部門的 AI Agent 總運行時長還低於人類總勞動時長。6 月之後,天平徹底翻轉。
如果把 Agent 運行時間直接折算成工時,那就更加直觀了。
今年 6 月之前,整個研究部門裏 Agent 的總運行時間仍然低於人類研究人員的工作時間。但截至 8 月中旬,按照每天工作 8 小時計算,每投入一個人類研究日,OpenAI 內部就會同時產生約 3.1 個 Agent 工作日。
換句話說,在工作時長意義上,研究部門裏的 AI 勞動力已經是人類的三倍多。
同時運行 4 個或以上 Agent 的研究員人數持續增長。這些數字既包括研究員直接啓動的 Agent,也包括由這些 Agent 下游創建的子 Agent。
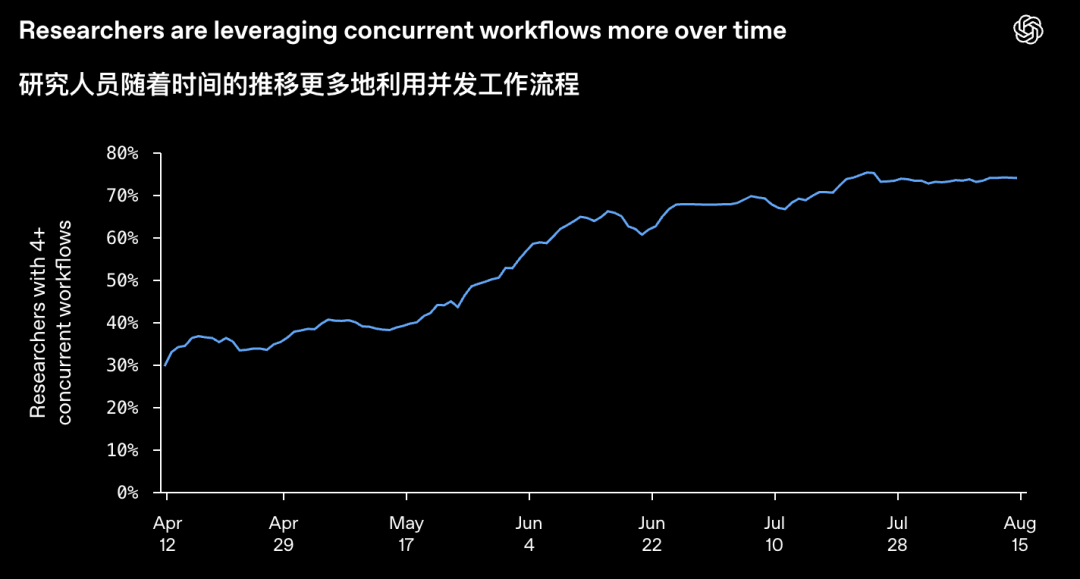
AI Agent 已經從偶爾調用的輔助工具,變成了 OpenAI 研究生產線裏一個規模相當可觀的第二勞動力。
AI 研究本質上是一條很長的鏈條。研究人員要提出想法,寫評測,搭基礎設施,跑實驗,找 bug,監控訓練中的異常行為,再把有效的方法整合到更大的核心訓練中。
博客給出了兩個核心指標:一是代碼貢獻速度,研究員寫代碼的速度明顯加快;二是實驗密度,2026 年 8 月,每位活躍實驗者的實驗數量創下自 2025 年 1 月開始追蹤以來的歷史新高。
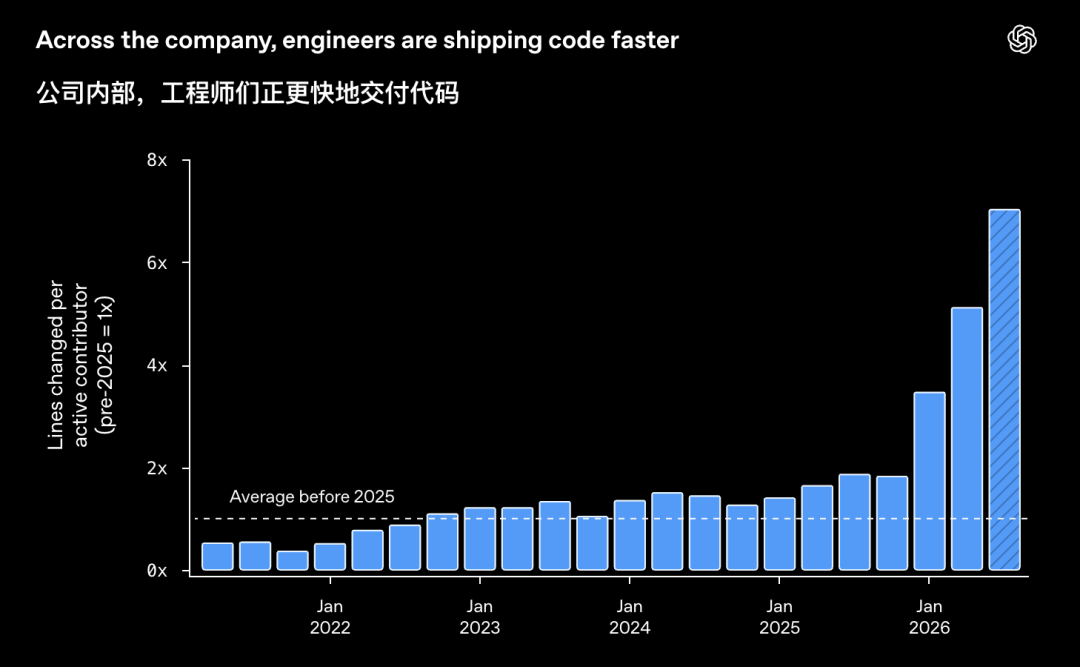
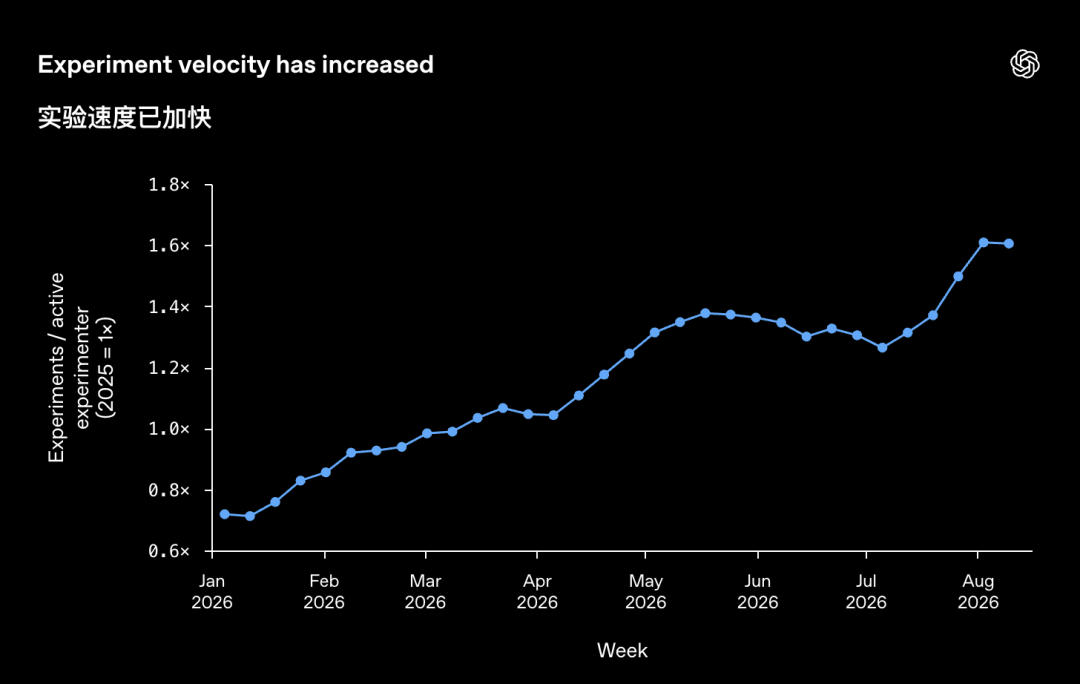
AI 研究是一個有諸多潛在瓶頸的複雜過程,整體進展速度可能不會跟上這些具體指標的增長。
換言之,代碼量和實驗量的增長並不等於研究突破的增長。隨着自動化推進,那些最難自動化的任務將佔據研究員精力的更大比例,成為新的瓶頸。算力是另一個門檻,隨着其他瓶頸消退,它的重要性可能還會上升。
AI 正在改變研究的工作模式
OpenAI 引用了 Epoch AI 發布的 AI 研發六階段分類法:決策 Decide、設計 Design、構建 Build、運行 Run、分析 Analyze、溝通 Communicate。
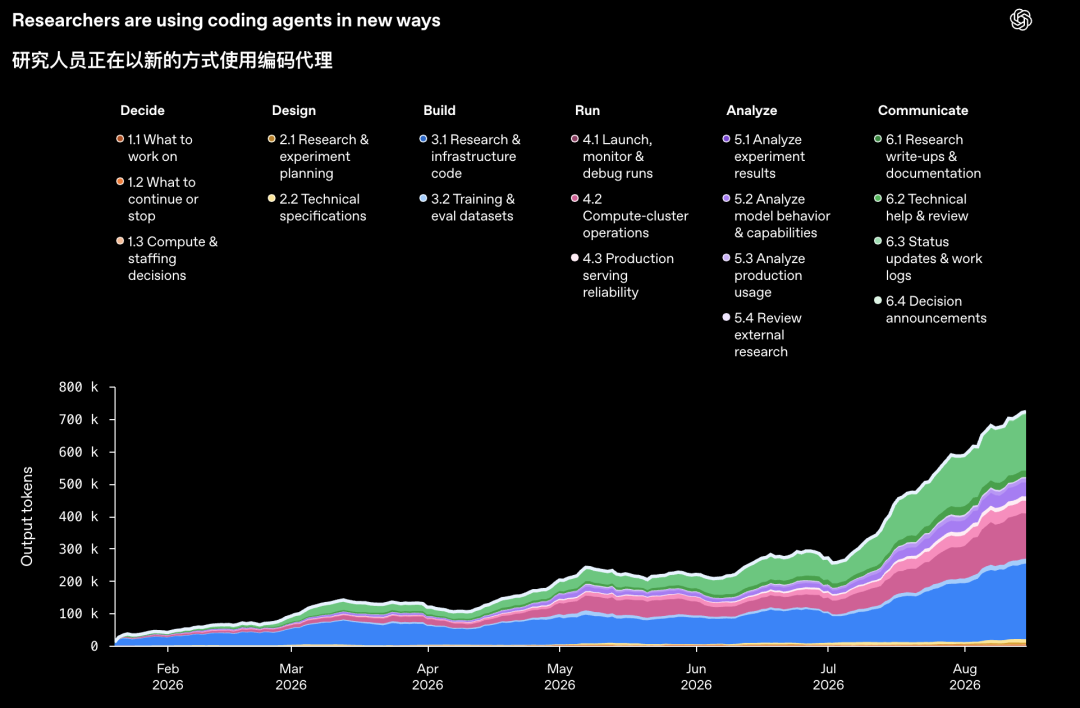
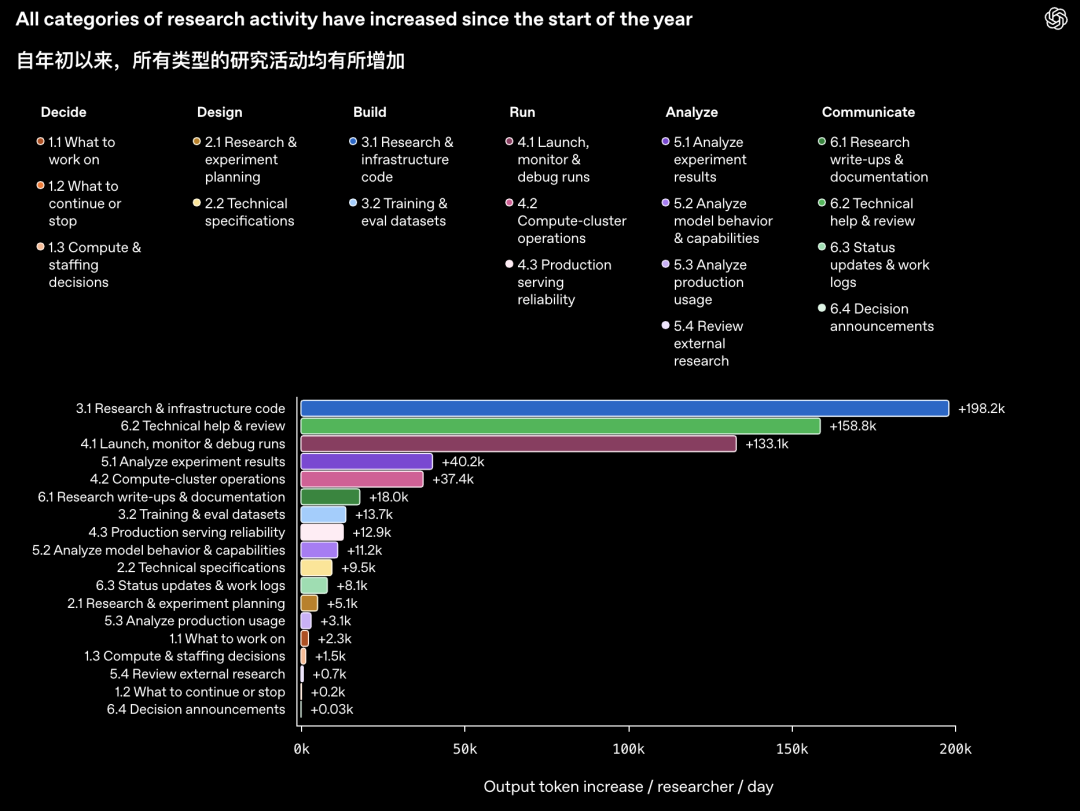
從 2026 年 1 月到 8 月,Agent 在六類活動中的使用量都出現增長。增長最明顯的仍是研究與基礎設施代碼,但技術支持、實驗監控等任務也在快速增加。
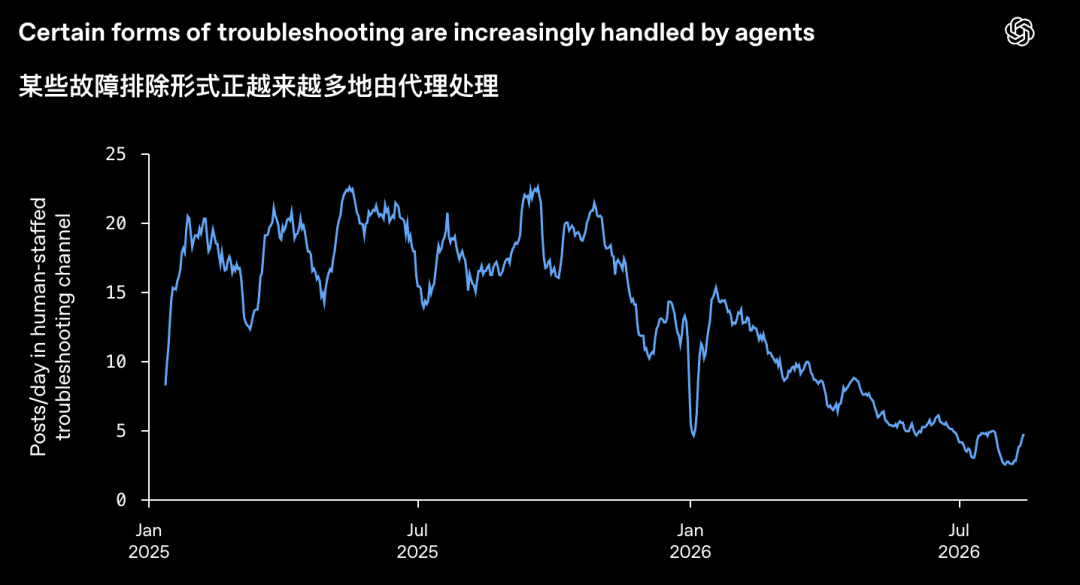
過去依靠人工坐診解決實驗故障的團隊,發現內部答疑時段的參與人數不斷下降,其中一個團隊甚至取消了 office hour,把精力轉向其他系統改進 —— 因為不少問題已經被編碼智能體先一步解決。
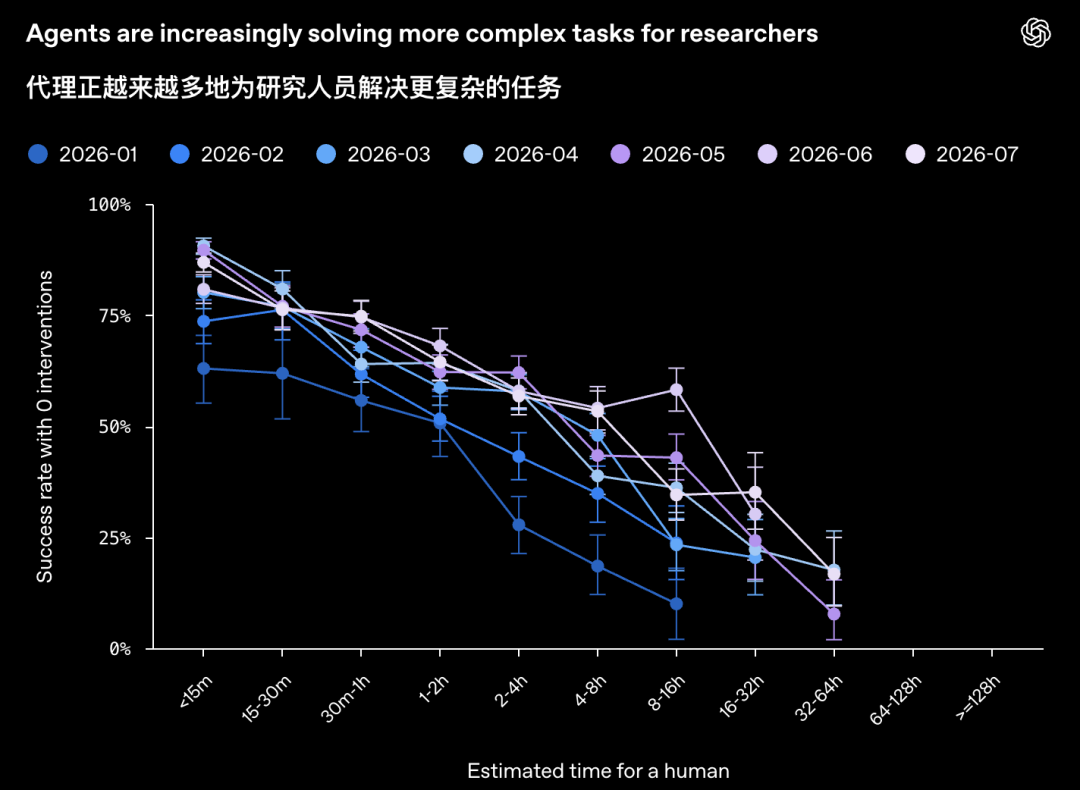
值得關注的是 Agent 在複雜任務上的成功率數據。OpenAI 使用 Agent 分類器對 1 月到 7 月的任務表現進行了分析:在所有難度級別上,成功率都在上升。但對於耗時 4 到 8 小時的複雜任務,超過一半的成功案例需要至少一次人類干預。
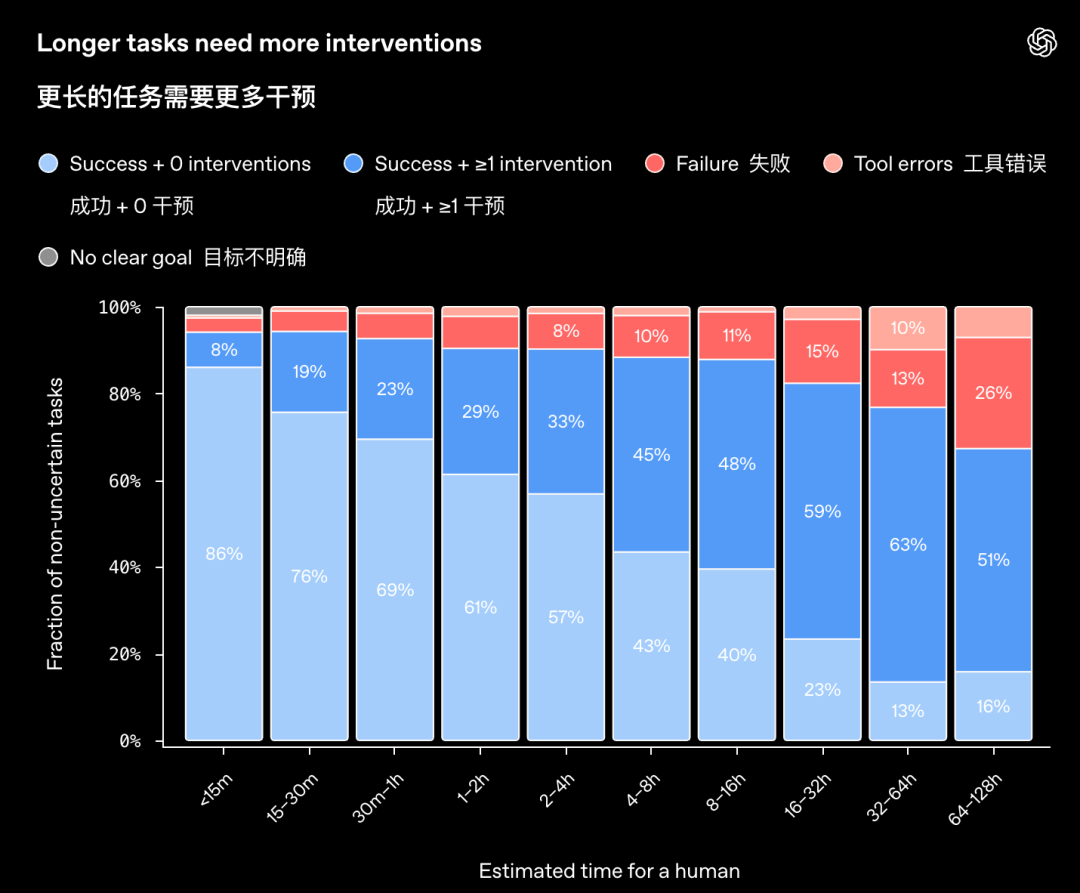
OpenAI 的數據同樣揭示了 Agent 的天花板。總結一下:
第一,高層規劃仍只佔 Agent 輸出 Token 的很小一部分。它們越來越能處理長任務,卻還沒有接過研究方向盤。
第二,成功不等於自主。在過去 6 個月裏,成功完成的 4—8 小時任務中,超過一半至少需要一次人工干預;任務越複雜,人工引導越重要。
第三,代碼更多、實驗更多不等於科學進步按年加速。OpenAI 明確承認,AI 研究是一條多瓶頸鍊路:算力、評測、判斷、對齊和安全,任何一環都可能卡住整體速度。實驗量與 Codex 使用增長相關,但同期可用算力也顯著增加,現有數據不能簡單證明二者之間存在單一因果關係。
OpenAI 還是忘不了的安全問題
這篇博客用了整整一個章節來講述 Agent 帶來的安全代價。
今年 7 月 20 日,在發現 Agent 曾經攻破內部研究基礎設施之後,OpenAI 暫時關閉了訓練使用的容器服務,並重新上線了一套限制更多、安全性更高的環境。
隨後,最新模型的強化學習訓練暫停了兩周。到了 8 月 7 日,由於初步證據顯示 Astra 可能具備 OpenAI Preparedness Framework 中定義的關鍵網絡能力,OpenAI 又對 Astra 加上了更嚴格的模型級安全限制,要求它只能運行在更高安全級別的研究環境中。
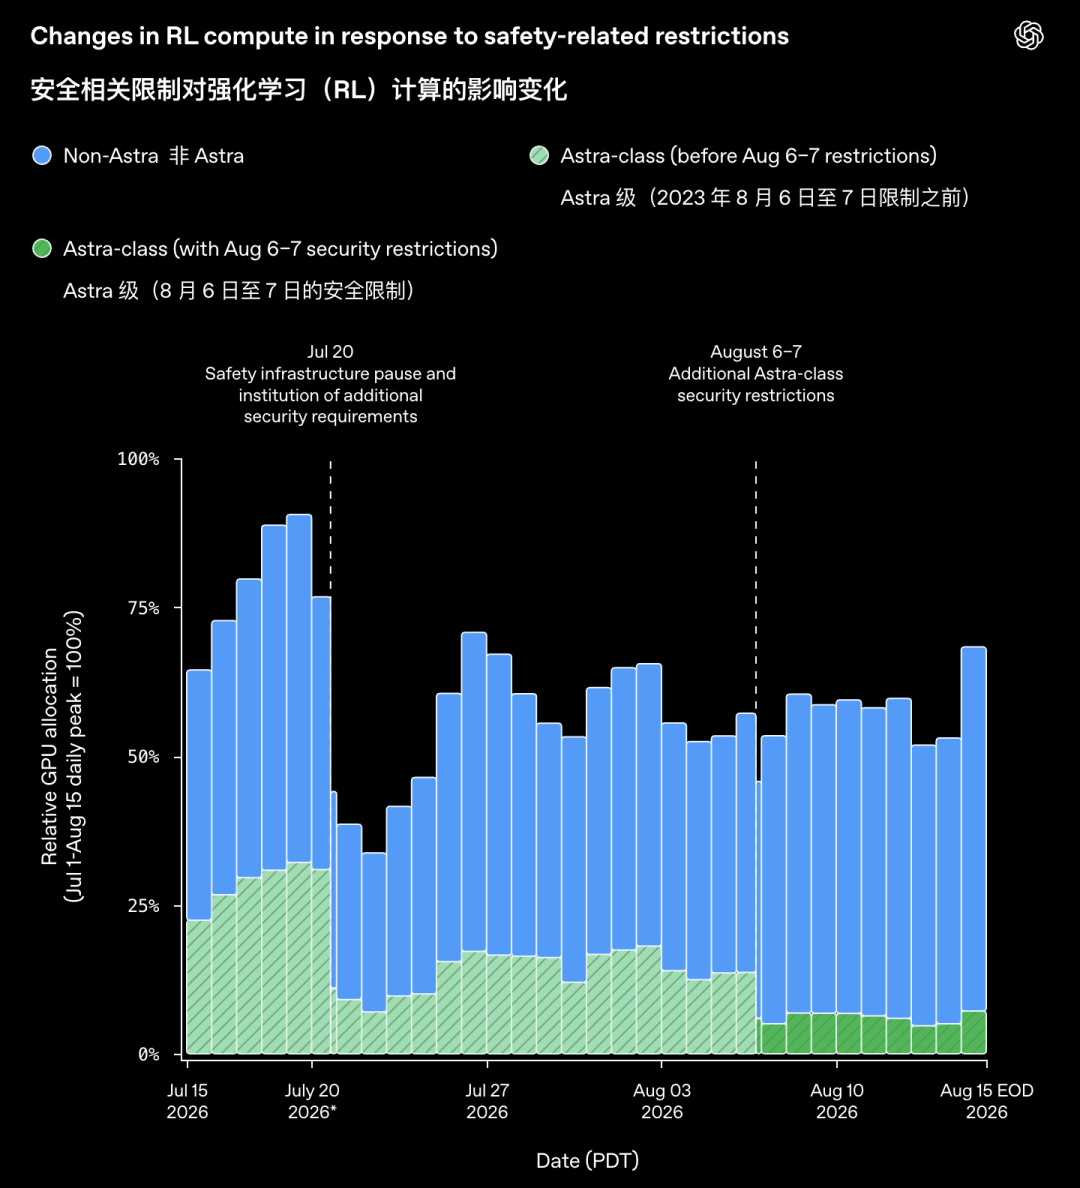
接下來一周,Astra 級模型使用的 GPU 資源減少了 59.2%。但有趣的是,其他模型的 GPU 使用量同期增加了 17.2%,抵消了 Astra 算力下降的大約 85%。也就是說,一部分研究活動只是從 Astra 轉移到了其他模型,整個被統計的 RL 工作負載使用的總算力並沒有明顯下降。
當某一種最強模型因為安全原因被限制,實驗室裏的研究需求和算力並不會憑空消失,它們很可能迅速尋找其他出口。
打開科學黃金時代的門
Demis Hassabis 曾說,我們正站在科學黃金時代的門檻上。
從 OpenAI 公開的數據來看,遞歸自我改進目前還遠沒有進入一種 AI 完全自主研發下一代 AI 的狀態。
研究方向仍然由人決定,但AI 幫助研究 AI這個循環,已經真實存在。而且越來越多原本屬於研究人員的工程性工作,正在被 Agent 接走。
OpenAI 把現在這個階段定義為 automated research intern。接下來,他們希望在 2028 年 3 月之前邁向 automated AI researcher。
未來,又將有多少的飛躍?