專題:中國國際服務貿易交易會 物理AI與具身智能機器人創新生態交流會
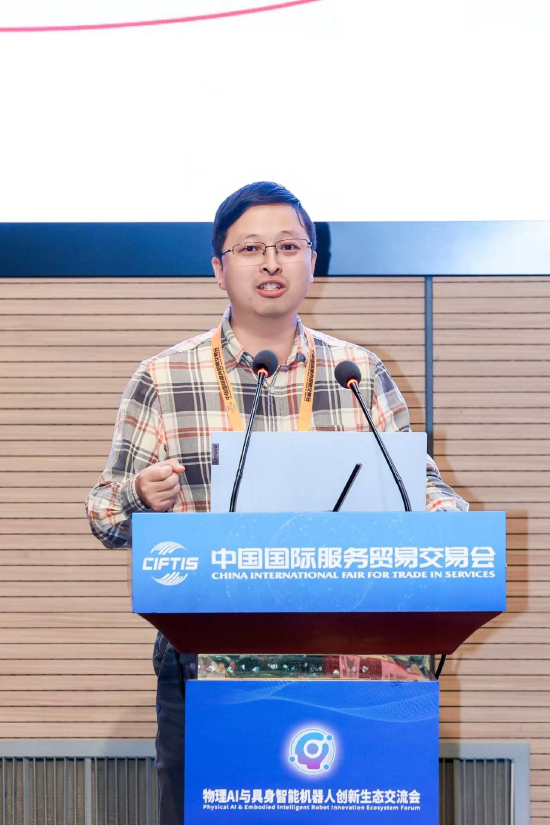
服貿會專題活動「物理AI與具身智能機器人創新生態交流會」於2026年9月11日在京舉辦。影身智能創始人兼CEO閔偉出席並演講。
以下為演講實錄:
閔偉:尊敬的張峯書記,尊敬的各位領導、各位來賓、各位企業家、各位媒體朋友,大家上午好。
我今天給大家帶來的演講題目是《共建原生4D世界模型,邁向通用物理智能》,我覺得咱們主辦方安排得非常好,第一個演講講的是本體,第二個馬上就到模型了。
我先解釋一下,我們想要做的這個模型是一個原生4D的世界模型,未來做4D呢?4D是三維的空間+一維的時間,其實是符合第一性原理的,因為我們所在的物理世界是四維的,它是三維的空間+一維的時間。我們講的具身AI,或者通用的物理智能,核心要有一個基座,這個基座一定是四維的,其他的觸覺、聽覺,各種摩擦,它本質上是四維時空組合的一個物理的現象,我們只需要對最基礎的四維時空做重建、理解、生成和預測,就能夠得到一個4D的基座,承載更多的物理規律。
從歷史上看每一次關鍵的技術變革都是數據推動的,我們看最早的imageNet,因為海量數據的打標,第一次實現了標註的圖片從1萬量級到100萬這個量級,100倍的躍升,帶來了整個人工智能的起點。後面到一維的大語言模型、二維的視頻生成模型,都是解決了海量數據的問題。因為大語言模型是解決了無標註的問題,二維是因為互聯網上已經有海量的視頻了,到4D時代,進入物理世界,最大的挑戰是什麼呢?我們是缺4D數據的,目前對於機器人來講為什麼我們的機器人經過3年的發展還在馬拉松的賽場上沒有真正進入生活、進入工廠、進入到大家真正需要它幹活的地方,最主要的原因是因為它缺乏泛化能力。泛化能力我們理解最核心的關鍵點是數據,我們的機器人在4D的世界裏面,訓練它用的是一維的語言和二維的視頻,但是它幹活需要處理的信息是四維的,這也是我們特別關注的一點,為什麼我們人有這麼好的泛化能力?我們理解人是用4D數據來訓練的。
現有整個行業4D數據是非常稀缺的,整個行業4D數據有Demo演示的,包括最近半年特別火的生成式數據、無標註的數據,它的核心還是以視頻為主,以人工標註的作業的4D的數據集,但是非常的稀缺,整個行業只有1500小時。另外還有仿真和虛擬的數據,這個數據它有一個Sim2Real GAP的行業難題很難解決。
我們對數據的看法,從今天開始整個數據行業比數據的採集來講更重要的是數據的演練。採集是勞動密集型行業,在自動駕駛時代我們已經經歷過了,海量的車在上面跑需要標註,海量數據收集回來。在具身智能時代比數據的採集更重要的一點是什麼呢?是數據的演練能力,從海量的各種視頻也好,或者是語言也好,低維的數據裏面如何抽取演練出高維的信息,這是當前更重要的一點。所以我們現在提出了我們自己要通過模型的能力來演練出高維的數據,這一點也特別讚同前一位演講者提到的,要用大模型去解決問題,所以我們自己提出了環繞多視角、稀疏視角的數據採集和演練,通過在一個場景架幾個攝像頭,然後實現無切入的採集,進一步降低成本,比一個生成數據的成本會更低。因為採集真實數據如果需要人員佩戴頭環設備,就要向佩戴頭環人員支付費用。第二個做多視角的對齊,最後我們把物理信息通過模型做一個演練,像中國的稀土一樣。我們中國的稀土,全世界都有稀土,但是演練能力最好的是中國。數據也是一樣,數據在全世界任何一個地方都能夠採集,但是對於數據來說,最核心的是數據的演練和復刻的能力。
4D數據的優勢就是一條完整的4D數據可以當作一次物理實驗,那麼它信息的豐富度大大超過用語言或者視頻的。一個二維的圖片或視頻數據,那麼記錄的內容是像素和軌跡,對於模型來講,它自己要升維、要理解,非常困難,但對我們人來說很容易,你看一個視頻很快能在你的大腦中復原這個視頻到底怎麼回事兒,模型是很困難的。所以我們採集4D數據能夠更好的記錄幾何空間、幾何結構、遮擋關係、接觸過程,相當於是完整的物理實驗。
今天是來到了首鋼園,我們放了一個首鋼園的光場數據,也是今年春晚的時候劉浩存跳舞,這個節目叫《夢底》,它是4D數據非常好的在生活中的應用,用4D數據做了分身,就在首鋼園。
這個的主要問題是什麼呢?這個奢侈品,採集設備需要80個攝像頭,需要巨大的算力。為了解決這個問題,相當於在封建社會去鍊鋼,產量很低。剛好咱們在首鋼,也是鍊鋼的高爐,我們做了一個技術能夠去工業化,大規模的把數據4D化。我們現在已經做到了用6個攝像頭就可以實現4D數據的採集和演練。首鋼的高爐,我們把類似於封建社會的手工的小作坊做到大規模工業化生產,4D數據採集做了4D直播的Demo,就在服貿會的12號館,歡迎大家去看。
第二個是模型,我們對模型的理解是?具身的模型是什麼?是新一代適配具身的基座。具身的話,上一位嘉賓也講了我們現在有很多開源的模型,為什麼大家開源了呢?開源的意思就是這個東西還不成熟,只能夠發布出來讓全世界一起去測試去完善,不成熟的本質原因是什麼?本質原因我覺得只有一條,沒有針對具身的基座。現有的兩個路線,第一個VLA,它的基座是大語言模型。
最近關注新聞大家可以看到GPT6以後,網上有人說VLA已死,為什麼呢?你會發現GPT6就是最好的VLA。基座能力已經把VLA的能力覆蓋掉了。第二個就是今年特別火的WAM,WAM的基座是視頻生成模型,因為基座能力的提升帶來了模型整體能力的提升,所以今年基於視頻生成的世界模型的概念特別火。但我們想要說的是針對具身應該是4D的基座,基於對物理世界的理解,而不是視頻的生成,因為我們所在的世界不是由像素組成的,是由4D分子運動的點雲組成的。
我們做了一個實驗,這個是Seedance2.5,目前是字節最新發布的一個視頻生成模型。我們做了一個實驗,發現讓它生成一個非常簡單的繫鞋帶的視頻,一頭一尾是對的,中間各種步驟都是錯的。目前預訓練最充分、性能最強的2D視頻模型也難以建模精細的、靈巧的操作任務,本質上是對底層的理解是有巨大的問題的。
今年上半年整個學術界也紛紛向3D、4D方向轉,出了很多3D、4D的文章。這裏有一篇比較有代表性的,是李飛飛的PointWorld,也是通過4D的點雲來作為技術的表徵,但是沒有解決海量的4D數據怎麼來的問題。我們自己是有一個方法論的,我們做4D世界模型分4步:重建、理解、生成和預測,通過4D的重建實現4D的理解,通過理解實現生成,然後能夠補齊各種沒有看到的視角。非常有意思的是,這兩天李飛飛發了一個Atlas,裏面提到了Next Token變成了下一個視角的預測,和我們的想法不謀而合。
我們通過4D的數據建立一個4D的基座,最終實現超長的泛化,實現對世界的因果的理解,最終去理解物理規律。我們之前基於視頻或者基於語言的基座,他們最大的問題就是,模範學會了不等於理解了。最近有一個相當火的技術,也是最近半年一個生成的數據或物理數據特別重大的成果就是ICL上下文學習。它把原文理解的泛化變成了更多信息的模仿,我們的目標是用更少的收入實現更多的泛化實現更底層的理解。
最後就是我們需要一條能夠形成貫穿數據、模型與機器人的訓練閉環,通過多視角的採集實現4D的重建,實現物理信息的復現,在最後真機執行落到現實場景裏去。這是我們最近做的Demo,能夠實現一張圖片+多視角的收入+一句話實現4D的生成。
這個是另外一個Demo,一句話和一張圖片生成6個視角的視頻,加一個稠密的點雲。
這是我們和其他家單純做視頻生成的對比,與單純的視頻生成的對比來說,因為我們同步生成了稠密的點雲,所以能更好地保持時空的一致性,解決了視頻生成的幻覺問題。這個是我們很有意思的Demo,我們讓進入生活,做了一個切辣椒,只需要輸入一句話加一張圖片,能夠生成6個視角的視頻和一個稠密的點雲,實現毫米級的精度,準確的展現出切辣椒這個日常生活中常見的動作。
因為我們做這些行業,所以我們做了一個繫鞋帶。
在目的方面,我們選擇了雙柔性物體操作,開展柔性生產環節裏柔性物體的操作,第一個行業是製鞋。另外我們還有一個數字娛樂的賽道,源頭賽道:一套底座、兩條航道、一個飛輪。相比於兩年前我們剛創業的時候選擇4D這條路線,今年整個行業也快速地向我們靠攏,特別是World Labs發布了Atlas,國內也有頭部大廠在大力開發空間視頻生成模型。
這個地方我們是劃了一個二維的座標圖,兩條軸,第一條軸是橫軸,我覺得整個行業的發展都會從低維到高維,從一維的語言到二維的視頻,到真實的4D。縱軸是規模化交付,從演示到規模化進入真實世界,真正創造生產力。對於行業來講,我們覺得4D具身破局的關鍵是四件事情:數據、模型、真實場景、規模化交付。
下一階段,我們會繼續做4D數據的規模化採集,迭代原生的世界模型,並且在服裝鞋帽數據飛輪、數字娛樂的數據飛輪轉起來之後進入到更多的場景。
所以我們的理念是原生4D模型將成為與大語言模型、視頻生成模型並列的下一代的基座。
最後邀請與會的各位,我們一起來共建一個生態,就在石景山,我們站在石景山的潮頭,我們將開放4D採集、數據演練與基座模型能力,邀請大家一起共建物理陣容的世界基座。
謝謝大家!