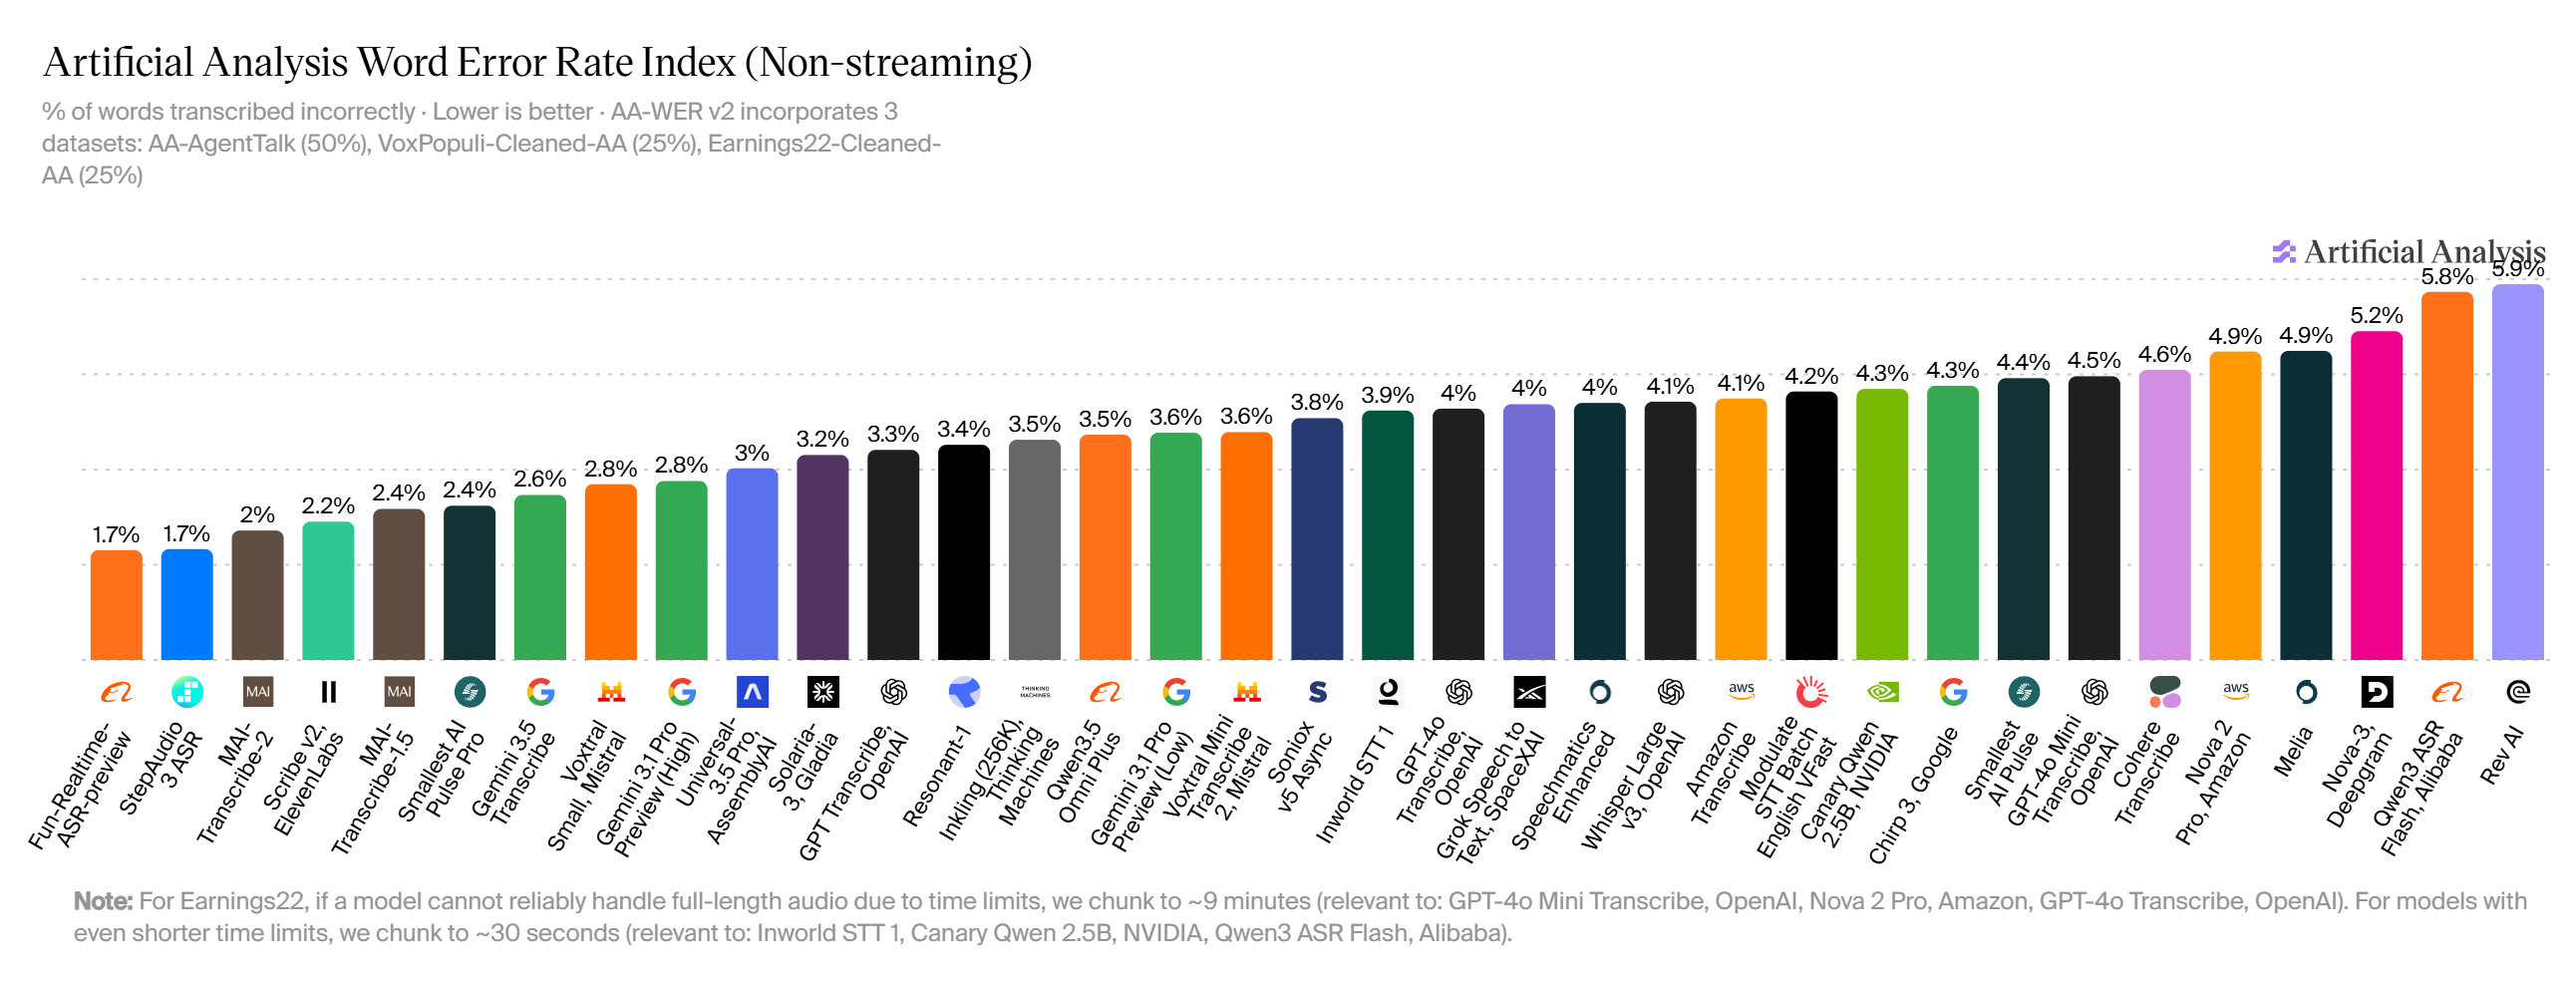
鳳凰網科技訊 9月15日,階躍星辰今日正式發布StepAudio 3系列語音大模型,包含StepAudio 3 Realtime、StepAudio 3 ASR、StepAudio 3 TTS、StepAudio 3 Gen和StepAudio 3 Music五款模型。多款模型在Artificial Analysis排行榜中位列全球第一。
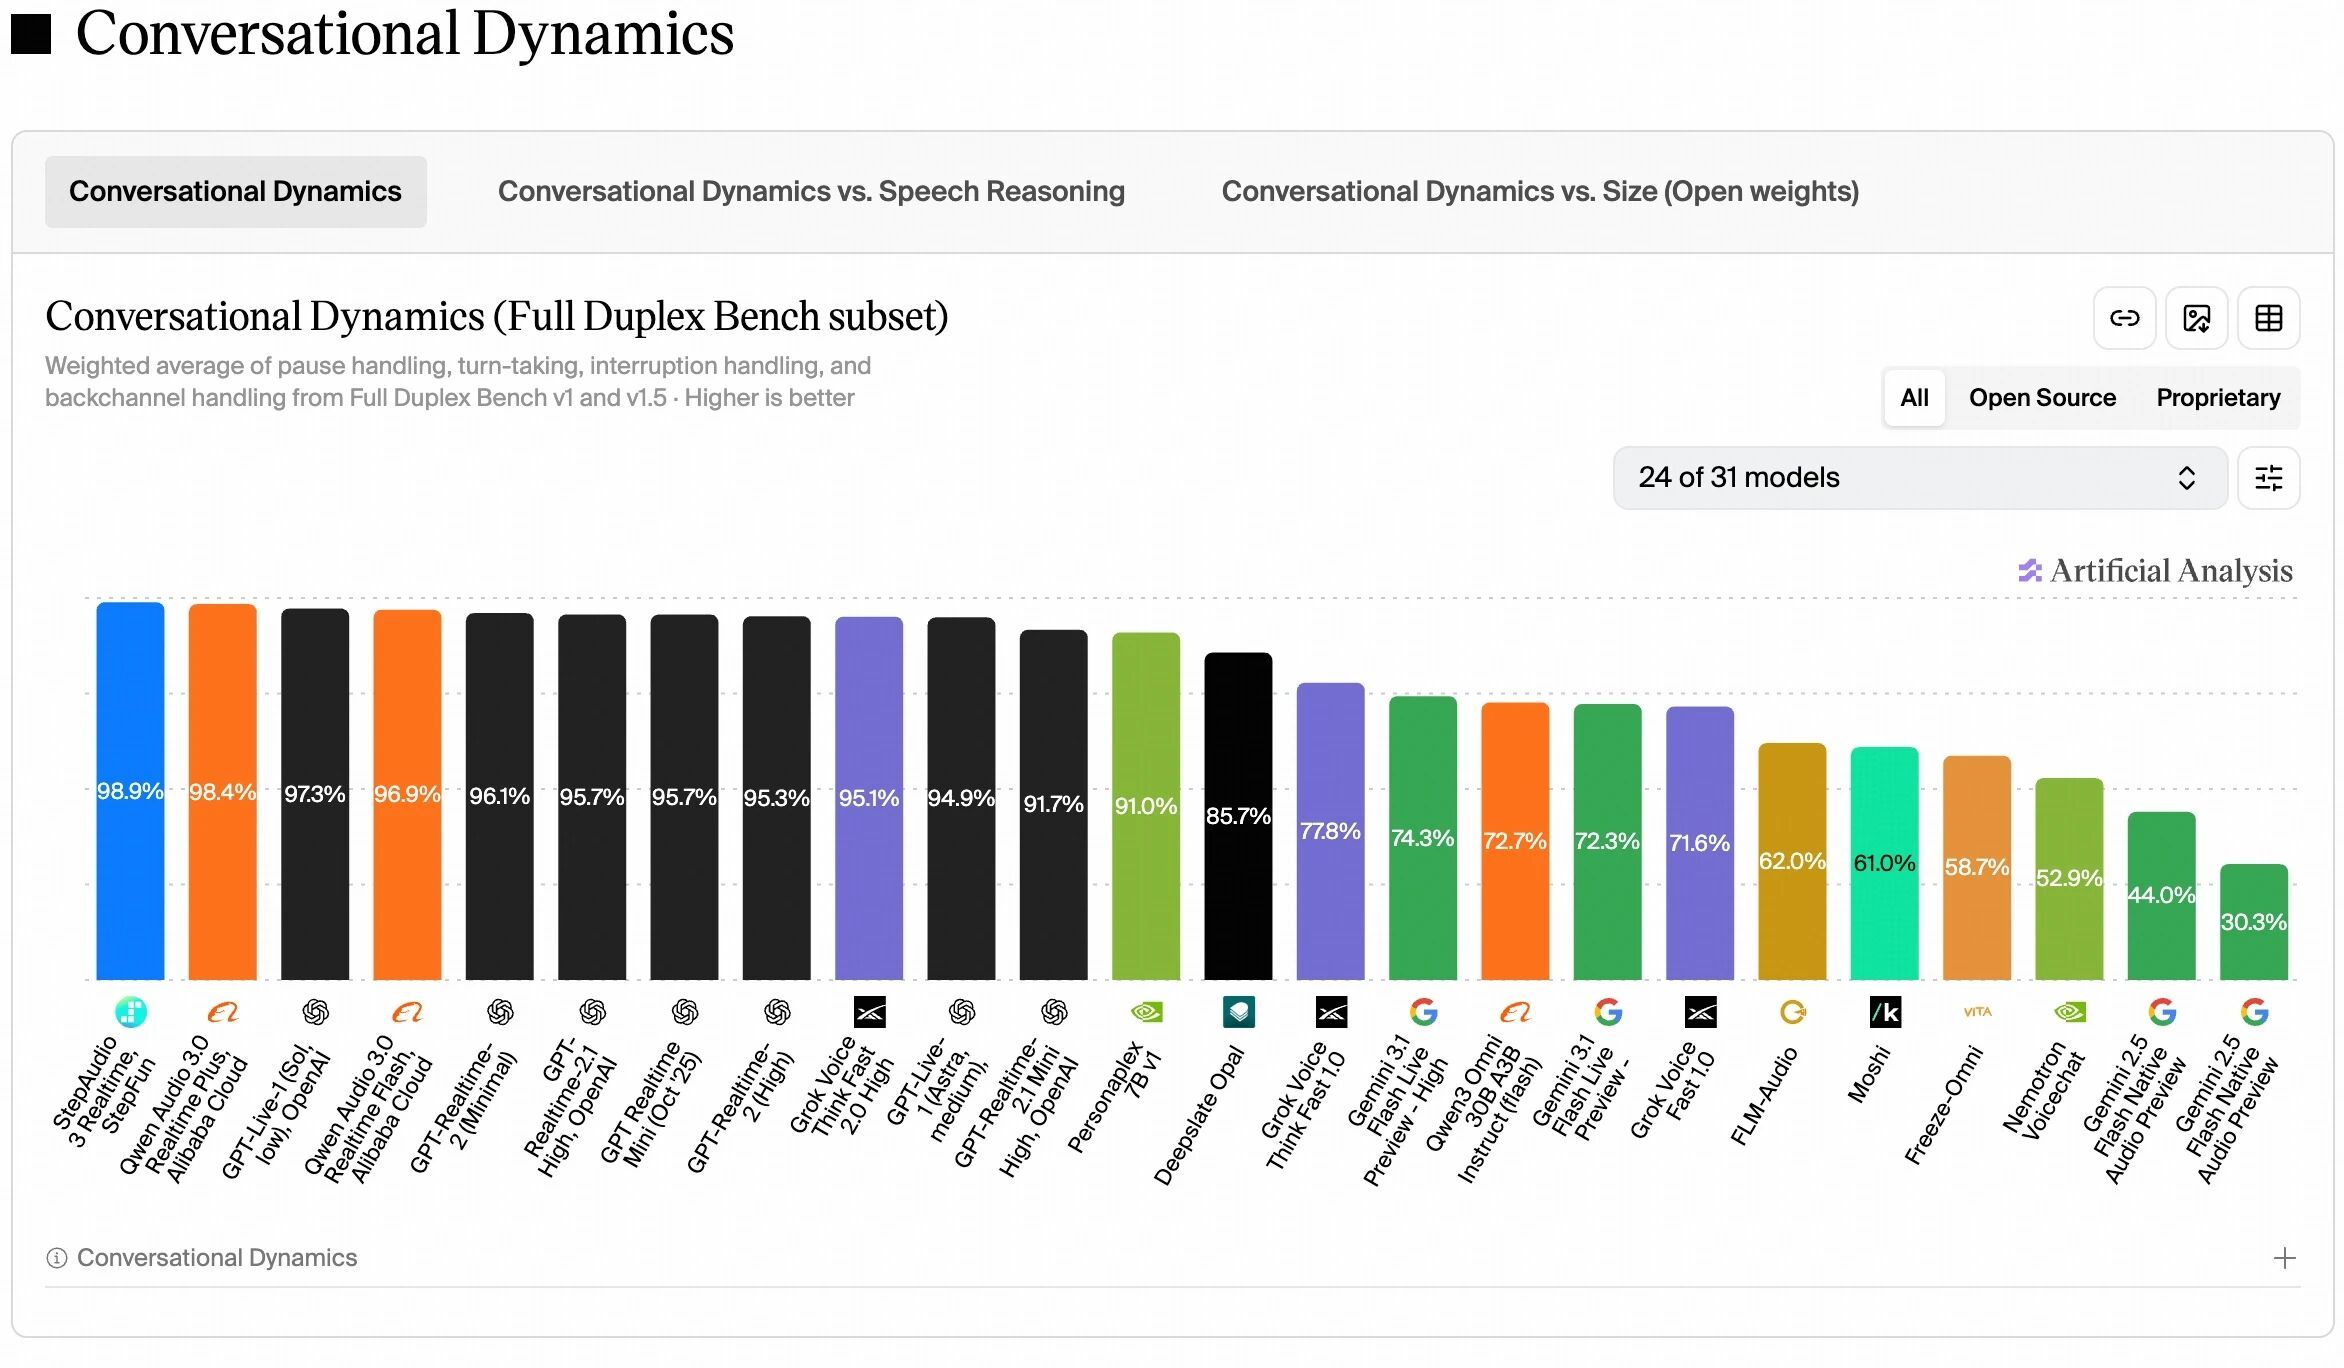
StepAudio 3 Realtime支持原生全雙工實時對話,在Artificial Analysis Conversational Dynamics排行榜中以98.9%綜合得分排名全球第一,在Speech Reasoning排行榜中以99.7%的語音推理準確率同樣位列全球第一。模型可同時理解語義、語氣、情緒、副語言和環境聲音,支持推理與語音生成並行,Tool Call和長任務可異步執行,不阻塞當前語音會話。
StepAudio 3 ASR將高精度語音識別與大語言模型的上下文理解能力結合,支持中文、英文、方言、中英混說、長音頻及專業領域識別,能夠處理低聲、快語速、含糊連讀、歌聲和背景音樂等複雜輸入,在醫療、法律、金融、汽車、編程等領域提升專業表達識別效果。該模型在Artificial Analysis非流式語音識別準確性排行榜中WER僅為1.7%,並列全球第一。
StepAudio 3 TTS面向實時交互場景,在音色基底、語調層次、節奏律動和氣口停頓等方面貼合人類自然口語模式,可還原笑聲、遲疑、結巴、重複、改口等副語言表現,並基於流式生成架構實現生成與播放同步。
StepAudio 3 Gen支持基於自然語言描述和參考音頻,統一生成人聲、音效、環境音和背景音樂,可對多個角色的音色、語氣、情緒、方言口音及笑聲、喘息等副語言特徵進行精細控制,並支持對白、音效、環境聲和背景音樂的時間與順序編排。
StepAudio 3 Music支持從零生成及基於ABC記譜法控制的多輪交互創作,覆蓋歌曲創作、清唱配樂、歌曲翻唱等功能,用戶可通過自然語言控制曲風、人聲、旋律、節奏、樂器、情緒及段落結構。模型還對主歌、副歌、橋段等歌曲結構及跨段落旋律發展進行建模,在清唱配樂場景中可理解旋律、節奏和情緒,並補充和聲、樂器及完整編曲。