隔夜美股科技大跌,費城半導體指數暴跌近6%,成分股全線下跌,存儲幾大巨頭也集體走弱。
為啥突然崩了?重要導火索——好幾家美國頂尖AI公司的CEO公開喊話,說要放緩技術發展。
「放緩AI開發」到底是什麼意思?
分三個層次看:第一種是模型發布節奏放慢,第二種是訓練規模不再猛擴,第三種是直接砍數據中心的資本開支。
這三種「剎車」踩下去,對AI硬件的影響完全不是一個量級。輕的只是商業化慢一點,重的直接動搖GPU、HBM的算力需求,最狠的那種,整條產業鏈的訂單和盈利預期都得跟着抖三抖。
AI巨頭到底在哪一層踩剎車,纔是判斷AI硬件接下來怎麼走的關鍵。
美股大跌,費城半導體指數暴跌近6%
北京時間9月15日凌晨,美股三大指數收跌。道瓊斯工業平均指數跌152.09點,收報52421.20點,跌0.29%;納斯達克指數跌146.63點,收報26186.41點,跌0.56%;標普500指數跌37點,收報7619.98點,跌0.48%。
多家美國頂尖 AI 企業 CEO 呼籲放緩技術發展,受此消息衝擊,AI 硬件產業鏈板塊股價顯著回調。
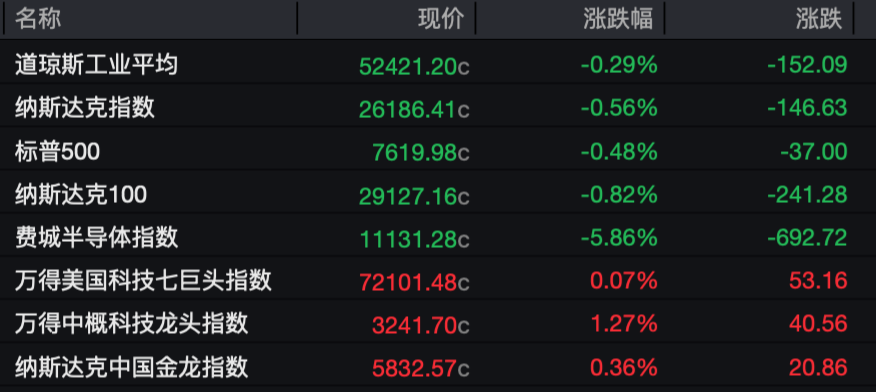
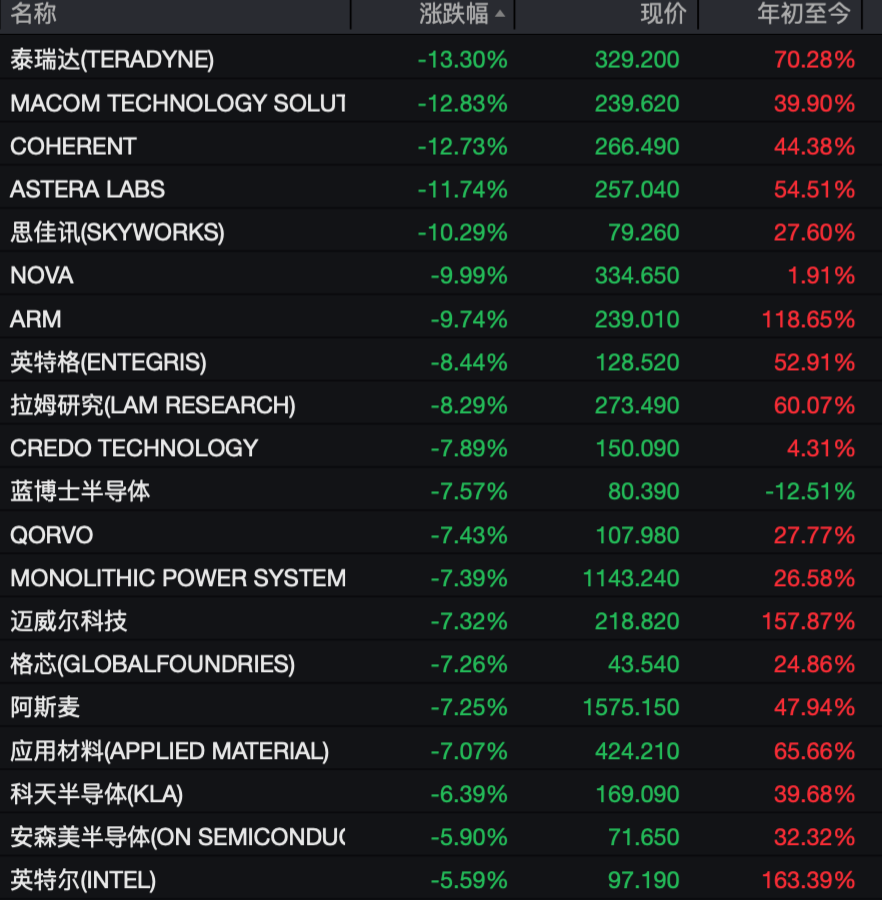
費城半導體指數重挫5.86%,成分股全線收跌。泰瑞達跌13.30%,COHERENT跌12.73%,ASTERA LABS跌11.74%,思佳訊跌10.29%,ARM跌9.74%,英特格、拉姆研究跌超8%,藍博士半導體、邁威爾科技、格芯、阿斯麥、應用材料跌超7%,安森美半導體、英特爾跌超5%。
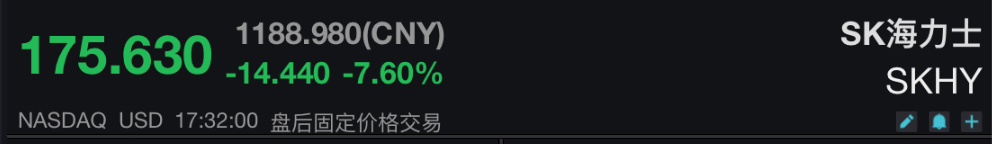
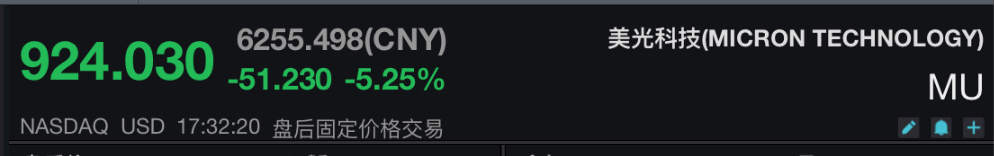
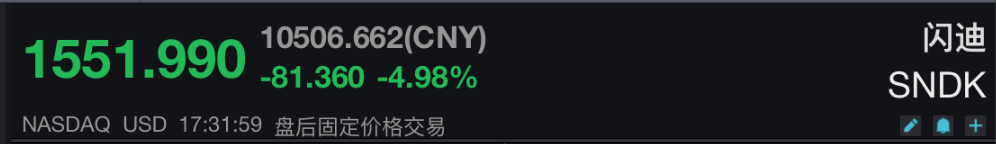
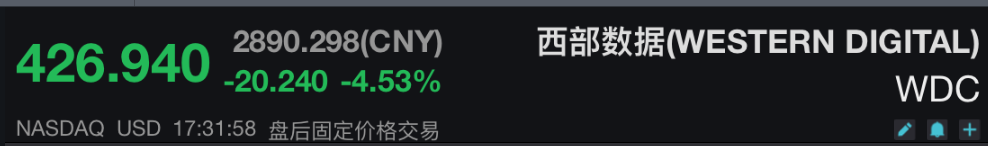
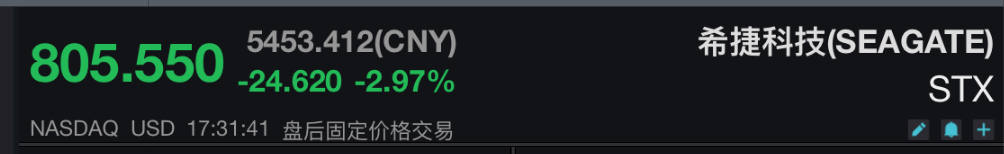
存儲板塊整體疲態盡顯。SK海力士跌7.60%,美光科技跌5.25%,閃迪跌4.98%,西部數據跌4.53%,希捷科技跌2.97%。
萬得美國科技七巨頭指數漲0.07%。谷歌漲3.06%,臉書漲2.71%,微軟漲1.97%,蘋果漲0.24%;亞馬遜跌1.26%,特斯拉跌1.77%,英偉達跌3.36%。
AI巨頭究竟準備在哪一層踩剎車?
把這次AI「減速」拆成三層來看:
第一種:模型發布節奏放慢——更多影響商業化,未必影響算力
先看影響最小的一種。
假設一家AI公司原本計劃10月發布下一代模型,現在因為需要增加安全測試、第三方評估和對齊工作,推遲到12月甚至明年才正式面向公衆開放。
這種情況下,模型發布慢了,但模型未必少訓練。事實上,Amodei此次提出的「pacing the frontier」也特別做了區分。他明確表示,「放慢」並不是停止模型訓練或技術進步,而是希望在模型能力提升的同時,留出更多時間進行安全、對齊及第三方評估。
這對硬件需求意味着什麼?
假如模型已經完成大部分訓練,只是延長評測周期,那麼此前消耗的GPU算力並不會因此「退貨」。更重要的是,安全評估本身同樣需要算力。模型需要做更長時間的紅隊測試、Agent模擬、強化學習、可解釋性研究以及大量推理測試。Amodei甚至提到,未來第三方評估者可能不只評估最終模型,也會直接檢查訓練和模型開發流程。
換句話說:模型晚發布 ≠ GPU少使用。
真正首先受到影響的,反而可能是AI商業化的時間表。如果下一代模型推遲幾個月推出,那麼依賴新模型能力的API收入、Agent產品、企業AI應用以及訂閱收入,可能同步後移。
因此第一種「放緩」對產業鏈更像是:軟件收入確認延後,但硬件需求未必同步下降。對英偉達、AMD、HBM、光模塊等AI硬件股而言,短期可能帶來估值和情緒波動,但還很難直接推導出盈利預期下修。
第二種:訓練擴張放慢——這纔開始真正碰到AI硬件需求
第二種情況就重要得多。
如果「安全放緩」進一步演變成:下一代模型不再快速擴大訓練規模,或者超大模型訓練頻率下降,那麼AI硬件需求才會真正受到影響。
過去兩年,AI硬件最核心的投資邏輯,就是下一代模型需要更多算力。從幾萬張GPU到十萬、數十萬甚至百萬卡集群,訓練規模不斷擴張,帶動GPU、HBM、先進封裝、交換機和光模塊需求爆發。
但「訓練放慢」也不能簡單等同於算力需求下降,真正需要看的是:單次訓練規模有沒有下降、訓練頻率有沒有降低,以及全年總算力投入是否減少。
例如,一家公司原本每年訓練4次大型模型、每次使用10萬張GPU,現在改成一年2次;但如果單次訓練規模提升至20萬張GPU,再疊加後訓練、安全評估、智能體測試等需求,全年實際消耗的算力未必下降。
因此,硬件投資者真正需要關注的,不是「大模型多久發布一次」,而是一年到底用了多少算力。
如果訓練算力真的下降,GPU和HBM將首當其衝,高速網絡也會受到影響。因為AI集群越大,對交換芯片、800G/1.6T光模塊、CPO等高速互連的需求越高。一旦百萬卡集群擴張節奏放慢,相關產業鏈原本較高的增長預期自然需要重新評估。
不過,這並不意味着AI算力需求就此見頂,因為另一股需求正在接棒——推理算力。
隨著AI從模型訓練走向大規模應用,尤其是智能體逐漸普及,一個任務往往需要多輪推理、搜索、工具調用和結果驗證,帶來的推理算力需求可能遠高於傳統聊天機器人。
因此,即使前沿模型訓練節奏放慢,只要AI使用量繼續增長,硬件需求更可能是從訓練端向推理端轉移,而不是簡單減少。未來AI硬件的競爭重點,也可能逐漸從「誰能提供最多訓練算力」,轉向「誰能以更低成本、更高能效提供更多推理算力」。
第三種:資本開支下降——這纔是AI硬件真正需要警惕的信號
相比模型發布和訓練節奏,資本開支纔是判斷AI硬件景氣度更直接的指標。
因為GPU、HBM、服務器、交換機、光模塊、液冷、SSD,以及變壓器、UPS、燃氣輪機等環節,最終都依賴一件事:科技巨頭是否還在持續擴建AI數據中心。
只要亞馬遜、微軟、Meta、谷歌等大型雲廠商仍維持高強度投入,AI硬件的訂單基礎就還在;反過來,如果這些公司開始系統性下調資本開支,才意味着產業鏈的盈利預期需要重新評估。
目前來看,這個信號還沒有出現。相反,大型科技公司的AI投資仍處於高位。
因此,現階段更準確的理解是:AI公司開始討論放慢前沿模型的能力提升速度,但基礎設施投資本身並沒有同步降溫。
市場擔心的,是模型開發放緩最終會不會進一步傳導至訓練算力、數據中心需求,最後影響資本開支和硬件訂單。
但目前能看到的,主要仍是前沿模型在安全和發布節奏上的調整,距離科技巨頭真正削減數據中心預算,還不是同一件事。
所以對AI硬件而言,接下來更值得關注的是大型雲廠商的資本開支指引有沒有開始下修。
哪些AI硬件更容易受到「放緩」影響?
如果把整條AI硬件產業鏈拆開來看,不同環節對「放緩」的敏感程度其實並不一樣。
GPU、HBM:最看訓練算力
如果只是模型發布延後,對GPU和HBM的實際需求影響有限。但如果下一代模型開始控制單次訓練規模,或者大型模型訓練次數明顯減少,那麼GPU與HBM會是最先受到影響的環節。
因此,對英偉達 、美國超微公司 、SK海力士 、美光科技 等公司而言,真正重要的不是新模型晚幾個月發布,而是下一代AI集群到底還需要多少算力、多少芯片。
光通信:最看集群能不能繼續做大
光通信對超大規模AI集群尤其敏感。GPU數量越多,芯片與服務器之間交換的數據量越大,對高速網絡、交換芯片、光模塊和CPO的需求也越強。
因此,如果未來百萬卡級AI集群的建設速度下降,光通信此前建立在「集群持續擴大」上的高增長預期就需要重新評估。反過來,如果只是模型發布延後,但數據中心和AI集群仍然照常擴建,對光通信基本面的實際影響也相對有限。
服務器、液冷:更看項目有沒有真正落地
服務器和液冷與數據中心實際部署的關係更直接。只要GPU還在交付、機櫃還在上架,相關需求就會繼續兌現。因此這一環節更需要警惕的,不是哪個模型推遲發布,而是數據中心項目本身出現延期、縮減甚至取消。
電力設備:影響通常更滯後
變壓器、燃氣輪機、發電設備等電力基礎設施的建設周期更長,不少訂單也會提前數年鎖定。因此,短期模型開發節奏改變,很難立刻影響已經開工的數據中心和電力項目。即使未來AI資本開支真的降速,電力鏈受到影響的時間通常也會晚於GPU、服務器等環節。
美股頻道更多獨家策劃、專家專欄,免費查閱>>