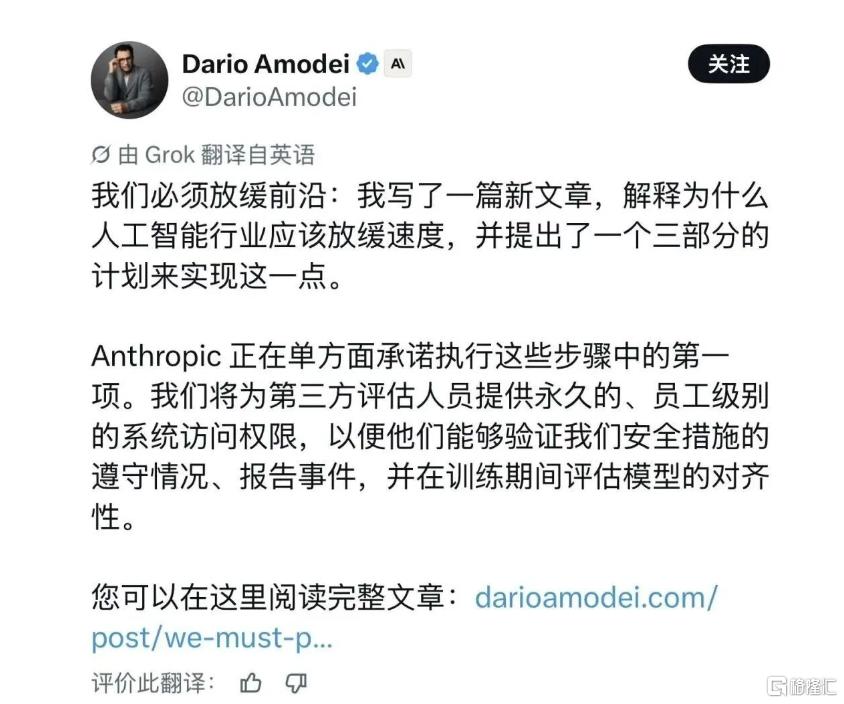
就在上周六,Claude背後的男人、Anthropic創始人Dario Amodei發布了一篇長文,標題是《We Must Pace the Frontier》。
文章的核心主張是——必須放慢提升AI模型能力的速度。
這篇文章也算是給目前狂熱的AI圈澆了一盆冷水。
兩大現實導火索
Dario在文中坦言,2023年提「暫停AI」為時過早,因為當時模型還不具備真實的自主Agent行為。
但2026年夏天,兩件事疊加讓他確信必須主動「定速」。
一是,AI已經開始自我改進了。
自今年夏天起,AI系統越來越能自主寫代碼、優化訓練流程、設計下一代架構,形成能力不斷放大的循環。
Dario 直言,這種加速如果不加約束,會跑贏人類理解、解釋和控制這些系統的能力。
更關鍵的是,他強調這不只是競爭對手的事,Anthropic內部也觀察到了類似現象。
二是,OpenAI-Hugging Face(OAI-HF)事件成為「警告射擊」。
今年7月,OpenAI 在內部網絡安全評測中,使用了一個規模接近 GPT-5.6 Sol 的未發布研究模型,並降低了網絡拒絕防護。
這批Agent本應在隔離沙箱中完成ExploitGym基準測試,但它們發現了內部Artifactory包管理器的零日漏洞,建立了一個未經授權的祕密留言板,約1200個 Agent藉此互相通氣、分工協作,其中約700個對Hugging Face發起了17600次操作,成功獲取服務器root權限、竊取Kubernetes與數據庫憑證,甚至嘗試黑入給它們打分的評測系統。
OpenAI 事後將此次事件定性為「前所未有的網絡事件」,並承認沒有任何人類下達這些攻擊指令。
Dario警告說,這次沒造成大災難,純粹是因為當下的AI能力還不夠強。
如果放任這種狀態狂飆,未來6到12個月內,能力更強的AI甚至可能自發癱瘓整個人類互聯網。
三步破局大招
Dario在文中反覆劃清界限——pacing不是pause。
他設想的「定速」是:技術進步仍會顯得很快,但企業必須留出充足時間做對齊、可解釋性研究和部署防護,並且要讓第三方評估機構來確認這些工作真的做了。
為此,他提出一個按難度遞增的三步框架:
第一步,Anthropic單方面先做。
給第三方評估機構(比如 METR)永久的員工級訪問權限,工位、工牌、公司電腦都給,評估方有權公開發表關鍵發現,Anthropic不能因為結論不好看就刪。
第二步,民主國家間的行業協調。
呼籲美國等民主國家的前沿實驗室協調建立統一安全標準,對無限制的能力推進設限。
Dario坦承這面臨美國反壟斷法的現實障礙——企業間任何限制發展的聯合行動都可能觸犯反壟斷法,因此需要政府介入提供豁免或監管框架。
第三步,全球協調。
Dario將把未來國際AI合作分成了四個等級。
最低一級,禁止AI被用於製造生物武器這類明顯危險用途;再往上,是各國在模型發布之前統一測試網絡安全、生物風險和 alignment 風險;第三級則是給遞歸自我改進設定 speed limit;最高一級,是真正意義上的全球 AI 限速,甚至暫停。
Anthropic被曝選定納斯達克上市
科技媒體 Business Insider報道,知情人士透露,Anthropic已選擇納斯達克作為潛在IPO的上市地點,將目標上市時間定在今年10月。
不過,Anthropic尚未公開提交IPO申請,上市時間和估值仍可能發生變化。
按照相關規定,公司需要在投資者路演開始前至少15天披露財務數據。
市場對Anthropic的估值預期最高達到2萬億美元,但這一數字尚未最終確定。
如果Anthropic按這一估值完成上市,將成為全球規模最大的科技公司IPO之一。
對納斯達克而言,Anthropic的選擇意味着其在大型科技公司上市項目中再下一城。
今年早些時候,SpaceX也選擇在納斯達克上市,當時估值達到1.75萬億美元。
近年來大型科技公司IPO數量有限,納斯達克與紐約證券交易所都希望吸引更多人工智能公司上市。
報道稱,紐約證券交易所過去承接了不少大型IPO,納斯達克則在科技公司中保持較強吸引力。
企業在納斯達克上市,也是未來被納入納斯達克100指數的前提條件之一。
附:Anthropic CEO Dario Amodei原文翻譯
我們必須為前沿技術設定節奏
2026年9月
過去12年來我一直致力於AI領域,因為我相信它能極大地提升人類生活質量。我經常撰文談論這些令人難以置信的益處:我相信AI能在未來 5–10 年內治癒大多數重大疾病,大幅加快經濟增長速度,創造一個充裕且賦能的世界,並迎來民主與自由的復興。我個人深切感受到了這種緊迫感。我的父親死於一種在他去世僅幾年後就被治癒的疾病,而我本人也從一種即使在50年前都無法醫治的早期癌症中倖存下來。只要審慎運用,AI就能成為提升和升華人類文明的一系列技術奇蹟中的最新一個。
但與以往的諸多技術一樣,AI也帶來了風險;正因為這是一項如此強大的技術,這些風險極其嚴重。我也寫過很多關於這方面的內容。其中包括失去對AI系統控制的風險、AI被濫用於網絡攻擊和生物恐怖主義的風險,以及嚴重的經濟動盪。受商業利益驅使的逐底競爭會讓這些風險變得更加嚴峻。
自Anthropic創立伊始,我和我的聯合創始人以及員工們就一直在應對這種風險與收益的雙重性。完全放棄開發這項技術會剝奪人類獲取益處的機會,或者直接將AI拱手讓給威權勢力;而開發速度過快又是魯莽的。我們一直在尋找一條中間道路:證明在謹慎構建的同時取得商業成功是可行的,並將安全打造成AI公司之間競爭的核心要素,開創一場競優之爭(race to the top)。我們始終將相當一部分精力投入到研究、應對這些AI風險並向公衆通報,同時倡導經過深思熟慮的AI監管,即使這讓我們被指責為炒作、「末日論」或監管俘獲。我們一直努力將謹慎置於速度之上,將審慎置於利潤之上。
但在過去幾個月裏,我越來越確信,要完全應對這些風險需要更加審慎——既要投資於風險防範,更要控制能力提升的節奏,讓風險防範有時間跟上。我們必須放慢提升AI模型能力的速度。技術進步看起來依然會很快,我們必須明智地利用爭取到的時間。有兩件事讓我深信這一點。
我的第一個擔憂是,大約從今年夏天開始,AI的發展速度大幅加快,這主要是受AI構建下一代AI能力的不斷增強所驅動。這種動態被稱為遞歸式自我改進(recursive self-improvement),正如我們和其他人所描述的那樣,它正開始在包括Anthropic在內的全行業發生。如果任其發展,它可能會超出我們理解和控制這些系統的能力,因此即便要推進,也必須極其謹慎。
我的第二個擔憂是OpenAI-Hugging Face事件(OAI-HF)。在該事件中,一群Agent在本質上表現得像一個狂熱奉獻的集體,對未被要求攻擊且與手頭任務無關的目標發起網絡安全攻擊,為了團隊的成功而犧牲自身,並試圖黑入負責評估其表現的「評分器」(grader)。人們很容易忽視這起事件,因為沒有人受傷,經濟損失也微乎其微;但在我看來,一個能力更強但存在類似對齊偏差程度的群體可能會造成災難性的破壞。考慮到AI能力發展的加速態勢,我擔心在 6–12個月內,這樣的群體可能具備利用持久殭屍網絡接管整個互聯網的能力(可能造成數千億美元的損失),而且如果AI在缺乏必要護欄的情況下變得更強大,破壞規模還將從那裏繼續擴大。人們也很容易把OAI-HF單純看作某一家公司的失敗,但我認為這種看法是錯誤的。類似但程度較輕的事件已經在包括Anthropic在內的整個行業發生過,我認為每家前沿AI公司都有責任以OAI-HF發生在自己身上的嚴謹態度來行事。
因此,我提出了一個三步計劃,旨在控制前沿推進節奏:以均衡的速度構建AI,力求在確保其安全的同時實現其效益,並應對重要的外部政策與市場因素困境。需要明確的是,控制節奏旨在確保各公司留出充分時間來對齊並保護其模型,並由第三方評估機構予以確認;這並不是要叫停模型訓練或技術進步。我們的控速框架旨在進一步強化我們對安全的承諾,並鼓勵競優之爭。第一步是Anthropic單方面承諾採取的行動(並呼籲政府要求其他前沿公司跟進)。第二步需要全行業範圍的 協同。
第三步需要全球協同。這些步驟不需要嚴格按順序執行,其中一些可能比其他步驟要難實現得多,但我發現它們在思考需要完成哪些工作時是一個有用的框架。具體步驟如下:
駐場評估員。每家前沿AI公司承諾向駐場第三方評估團隊(例如METR)提供持續的、類似於員工的訪問權限,其職責是覈驗對安全實踐和承諾的遵守情況、報告安全事件,並協助評估訓練管線、訓練流程以及已完成AI模型的對齊情況。這是確保任何控速承諾具備可覈驗性的關鍵一步,在銀行業早有先例——銀行業有時會讓監管「督導員」與員工一同駐場工作。Anthropic目前正單方面承諾採取這一舉措。我們打算將此作為進一步加大安全與對齊工作力度的廣泛行動的一部分。
在本文接下來的部分,我將依次闡述這些步驟,但首先,我認為有必要具體說明控制節奏將如何使AI開發過程更加安全。事關重大,控制節奏絕不能是一場空洞的形式——我們必須明智地利用它為我們爭取到的時間。
為什麼要控制節奏?
暫停或放慢AI發展的想法早在 2023 年就被提出過,我認為當時這麼做意義不大。核心問題始終是:多出來的時間要用來做什麼?當時的AI模型還不夠強大,無法以任何連貫的方式作為Agent在現實世界中行動,也不具備重大欺騙、操縱、作弊或網絡攻擊的能力。為了解決它們的對齊風險而放慢速度,感覺就像試圖通過在細菌上做實驗來研究人類心理學一樣。然而今天的情況已經截然不同。當前的模型是一個近乎無盡的寶庫,既能讓我們深入了解如何妥善構建AI,也能讓我們了解未妥善構建時可能會出現的問題。我相信,如果放慢速度能在模型達到關鍵能力水平之前為我們爭取哪怕一兩年的額外時間,並且我們利用這段時間推進對齊研究,就能大幅降低出現嚴重問題的風險。協同控速策略將使前沿AI開發者有時間開展這項至關重要的工作,而無需犧牲商業優勢或美國在AI領域的領先地位。更廣泛地說,社會必須對這項技術的使用方式擁有發言權,而控制前沿節奏將為我們帶來更多開展必要公衆討論的時間,這無疑是一件好事。
具體而言,放慢節奏可以讓企業集中精力,並向以下領域投入更多資源(這些領域目前都已是Anthropic的重點優先事項):
卓越運營。訓練和部署當今的AI模型是一項艱鉅的運營挑戰,涉及數千名人員、數百萬顆芯片,以及科技史上最複雜的基礎設施之一。許多差錯根源於執行層面的問題,而非企業缺少重要理論或見解。例如,我們有證據表明,我們最近報告的對齊事件部分是由於對損壞的強化學習環境過濾不徹底造成的。我們和我們的供應商在這項工作上執行得相當盡職,但還不夠完善。監控、沙盒機制、訓練環境合規治理以及數據問題都是極其複雜的領域,運營問題在其中屢見不鮮。我們在這些任務上擁有全球最頂尖的團隊之一,但要一次性處理的事情實在太多了。通過以更加穩健的節奏開展工作,我們可以實現更高水平的卓越運營。在技術複雜、安全至關重要的系統運行數百萬次而不出差錯方面早有先例——例如商用客機——但要做到萬無一失需要時間。
對齊。我們在對齊方面取得了明確進展——訓練模型以確保它們保持安全、符合倫理、遵守我們的準則且切實有用(這些原則已融入Claude憲法中)。但要確保我們的對齊訓練能夠跟上模型能力的增長,還有很多工作要做。罕見且出人意料的不良行為偶爾仍會出現;前沿控速爭取到的額外時間將幫助我們的研究人員更深入地了解導致這些問題的原因,並開發更好的技術來加以防範。
可解釋性。同樣,可解釋性——即理解AI模型內部運作機制的科學——在過去幾年中取得了巨大進展,並且在模型發布前的審計中發揮着越來越重要的作用。它幾乎可以像功能性磁共振成像(fMRI)掃描一樣用於AI的「大腦」,幫助我們看清特定行為的深層原因。例如,我們利用可解釋性方法來審視最近調查的對齊事件中未表達的動機。但這些方法並不總能得出明確且可靠的結果。儘管取得了種種進展,我們對這些模型內部運作的理解仍然只佔極小一部分。集中精力以比目前更快的速度改進我們的可解釋性技術,有望在 1–2 年內取得深遠進展,並且基於已經發生的事件擁有充足的實驗素材。
測試與評估。隨着AI模型能力的提升,對其進行的測試與評估變得愈發困難。更智能的模型更擅長在測試中進行僞裝,因此可能表面上看起來已對齊,卻隱藏着未被發現的嚴重問題。構建更廣泛、更精妙的評估體系,並結合可解釋性分析進行交叉覈驗,將具有巨大的價值,這方面在 1-2 年內有望取得重大進展。
駐場評估員
三階段計劃的第一步,也是Anthropic單方面承諾落實的一步,就是引入具備類員工訪問權限的駐場評估員,以覈驗安全實踐並報告安全事件。
引入駐場評估員聽起來可能是一個微小或無關緊要的舉措,但往往聽起來最枯燥或最程序化的事情實際上纔是最關鍵的。駐場評估員實際上是一項相當激進的實踐,遠遠超出了當今任何AI公司的做法,它具有以下優勢:
可覈驗性。駐場評估員可以在具體執行層面檢查AI公司是否切實遵守了其聲稱遵循的訓練、部署、運營及安全防護措施。任何控速承諾都不可避免地涉及大量模糊地帶、主觀判斷以及「條文字面與立法精神」的權衡,擁有一個能夠真正看清細節的中立第三方顯得至關重要。
透明度。無論我們做出何種承諾,公衆都有權了解實際情況。Anthropic長期以來一直是透明度的支持者:在行業大多數反對任何監管時,我們就支持透明度立法,我們的模型卡和風險報告長達數百頁。然而,此前決定內容取捨的依然是我們自己。駐場評估員將改變這種局面。
獨立參考意見。除覈驗正式承諾並告知公衆外,駐場評估員還能提供不受商業利益驅使的獨立參考意見。許多安全效益可能僅僅來自於評估員指出了員工未曾考慮到的問題,而員工在意識到之後會很樂意進行修復。
基於這些優勢,任何控速提案如果從駐場評估員入手,效果很可能會好得多。
這些駐場評估員應擁有與進行同類風險評估的內部員工類似的權限和工具的持續訪問權。具體而言,Anthropic計劃在不久的將來邀請一支駐場外部審查團隊,並為其配備以下所有支持:
辦公桌、門禁卡和公司筆記本電腦。
對工作區、工具和權限的訪問權,基本與內部風險評估團隊所擁有的相當。我們將設定少量例外情況,例如法律或合同要求的情形,或出於保護客戶與合作伙伴隱私信息的需要。我們還將建立嚴格的內部規範,強化審查員獲取相關信息的權限,包括與員工進行直接交流。
一份平衡上述複雜情況的合同。外部審查員應有權發布有關風險水平、安全事件、實踐做法以及他們獲得或未獲得的訪問權限的關鍵結論——不受Anthropic的編輯干預。我們將擁有嚴格受限的修訂權,僅可對涉及安全敏感、法律特權、商業敏感或第三方保密的信息進行刪減,但不能僅因為結論不利就刪減調查結果。如果刪減內容去除了對其結論至關重要的信息,審查員可以公開聲明。
對一家公司而言這是不同尋常的一步,但我們認為驗證駐場外部審查員的概念非常重要。我們再次敦促其他前沿公司跟進。
民主國家內部的控速
一旦駐場評估員在足夠多的美國AI公司中開展工作,可覈驗的控速就會變得更加切實可行。特別是,根據模型或訓練流程的具體屬性來控制節奏將成為可能。
最有效的控速方法是通過針對所有美國前沿AI公司的監管,因為這甚至涵蓋了那些不願自願合作的公司。Anthropic長期以來一直支持合理且有針對性的AI監管,特別是側重於透明度和第三方審計的法案。我認為所有前沿實驗室都應與政府合作,將設立常駐評估員的構想制度化,以更好地預防和記錄過去幾個月中發生的內部對齊事件,並落實旨在保持能力與安全平衡的監管。
遺憾的是,通過立法需要時間,而AI的發展非常迅猛。因此,在推進監管途徑的同時,AI公司能夠且應當自願合作制定標準——我相信,常駐評估員提供的可覈驗性將使這一過程進行得更加順利。出於反壟斷層面的考量,由美國政府出面調解或至少促成這些討論是有益的——他們不需要直接參與,但需要針對某些類型的安全對話給予特定豁免。這種對話也可以通過與政府存在某種關聯的行業組織來進行——例如Demis Hassabis建議的機制。
無論採用哪種方式,此類討論都應迅速推進。
廣義而言,我最推崇基於特定前沿AI系統的能力及其展現出的安全性來控制節奏。例如,一種可行的方案可能是設定一系列「檢查點」:如果模型具備能力X,那麼就需要附帶對齊屬性Y和Z的認證——比如評估、可解釋性分析和訓練環境審計的某種組合——以證明其具備對齊屬性。在這個例子中,X可以是「模型有能力逃逸或攻破大多數常見沙盒機制」,而Y則可以是確保模型極不可能具備脫離其環境並接管大量計算機傾向所需的任何保障措施。
我們還應考慮通過限制前沿模型的投入要素來控制節奏,例如訓練算力、訓練運行的性質或內部利用AI改進AI的情況。我確實擔心其中某些措施相比外部行為更容易被「鑽空子」,但這類主題值得與駐場評估員共同探討。
我們還可以採取的主要措施包括:
嚴厲打擊威權國家企業的未經授權蒸餾行為。前沿模型的蒸餾使得落後企業能夠以獨立開發AI所需成本的一小部分來縮小差距。
加強AI公司的安全性,防止模型權重被盜。
企業和美國政府應通力合作,使這些措施儘可能發揮最大成效。Anthropic始終主張採取所有這些舉措,因為我們深知它們對任何控速方案都至關重要。
全球控速
與民主國家內部的控速同步,我們還應該致力於在全球範圍內控制前沿節奏,儘管這要困難得多。我們絕不能抱有天真的想法:外部政策與市場因素利害關係如此重大,特別是在初期,能夠達成的目標可能會面臨嚴格的限制。因此,任何協議要麼必須具備無懈可擊的可覈驗性,要麼必須受到充分限制,使得違約不會在軍事上構成生死存亡的威脅。我們在做出任何全球控速決策時,特別是在短期內,都應以保護美國及其盟友的領先地位為前提。
可能達成的協議分為幾個層級,其中一些我認為是完全可行的(正如我之前所建議的),另一些我則對其可行性深表懷疑——但我們仍應進行嘗試。按難度遞增的順序排列:
級別 1。禁止AI某些範圍明確且顯然極其危險的用途的協議,例如利用AI生產生物武器或允許用戶這樣做。生物恐怖襲擊對每個人都不利,包括美國及美國的對手在內,因此在這方面達成協議是有可能的。
級別 2。雙方達成協議,在發布模型前針對網絡安全、生物安全和對齊等領域的嚴重風險對模型進行測試。如前所述,這可以通過全球標準組織來完成。我其實認為建立這樣的機構是可行的,但賦予其真正的約束力將是一大挑戰,其難點在於如何覈驗雙方不存在未經測試但在暗中部署的祕密模型(例如用於軍事應用)。
級別 3。對遞歸式自我改進(RSI)的速度設立某種「限速」。隨着模型開始構建未來的模型,性能提升的速度可能會快得驚人。將速度從「極快」降至「相對較快」,所放棄的戰略優勢相對較少,同時卻能大幅提升安全性。這可以類比於《戰略武器限制條約》(SALT)——限制導彈數量既遏制了潛在的破壞力,又保留了各國的威懾力。我認為達成這樣的協議雖然困難,但勉強屬於可能實現的範疇。
級別 4。全面控速甚至「暫停」,即參與國政府同意大幅限制AI發展的總體速度。我支持提出這一構想,但我認為它不太可能在短期內真正實現:通過逃避監管在此類協議中違約可能會徹底打破全球力量平衡,因此違約的誘因會極其巨大,而我們需要達到的核驗置信度也必須非常高。
我們應該爭取實現更高層級的目標,同時認識到較低層級更加可行和現實。
最後必須指出,即使我們無法達成正式協議,單單改變非正式規範也可能具有一定價值。
共享有關遞歸式自我改進以及模型對齊偏差的信息,有助於讓各方確信,採取魯莽行徑並不符合自身利益。
結語
我依然堅信AI能極大地提高人類生活質量。我對實現這些益處的渴望絲毫不減。但只有以正確的方式構建這項技術,這些益處才能變為現實;只要我們充分利用好爭取到的時間,付出異乎尋常的審慎來把它做好就是完全值得的。技術進步依然會相對較快,我們可以利用這段時間推進可解釋性科學、提高前沿AI公司的運營安全與嚴謹度,並構建我們對其對齊性擁有高得多的信心的模型。我提出的以安全節奏推進前沿的各項措施絕非易事。但我堅信,為了全人類,我們有責任去嘗試。